论文表格怎么提取到Excel?我用20个样本横测3款解析器
- 2026-09-24 08:35:53
论文里的表格,最折磨人的往往不是“看不清”,而是“拿不走”。
鼠标框选,粘贴进 Excel:五列变一列;多层表头散成十几格;脚注混进数据;公式里的竖线又被当成分隔符。最后你发现,手工修表的时间可能比读论文还长。
所以这次我没有再测“PDF 能不能转成 Markdown”,而是把问题收窄到一个非常具体的动作:
论文表格提取出来以后,距离“能在 Excel 里继续分析”到底还有多远?
我从 8 篇公开论文的保留实验输出中整理出 19 个真实表格或表格型结构,再加入 1 个“外观看起来像表格、实际是示意图”的负样本,对 Docling、MinerU、Marker 做逐表人工复核。
先说结论:
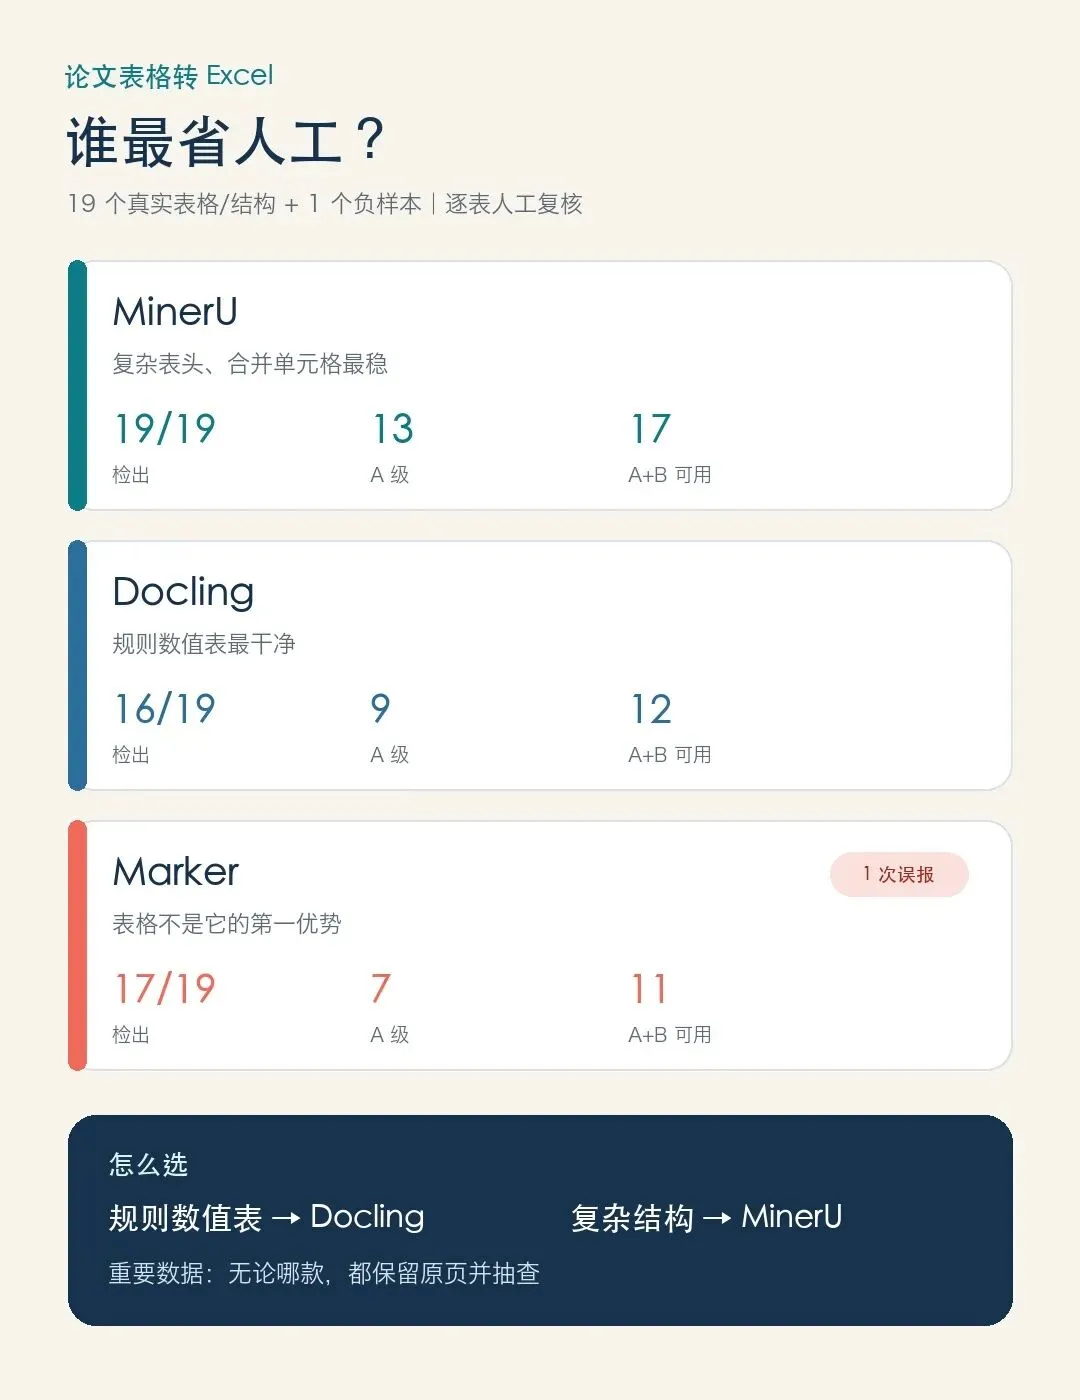
规则数值表,Docling 最省事; 多层表头、合并单元格和结构型表格,MinerU 更稳; Marker 的优势仍然是页码追溯,不是表格转 Excel; 无论用哪款,关键科研数据都不能省掉原页抽查。
这次怎么测:不做虚假的“综合准确率”
样本来自 Attention、ResNet、Whisper、BERT、GPT-4 Technical Report、Docling Technical Report、Table Transformer 和 LayoutLMv3 的前 6 页。
里面既有 3 列的小数值表,也有 10 列宽表、两层表头、跨行跨列单元格、公式符号、脚注,以及把算法步骤装进网格的“表格型结构”。负样本是 BERT 的输入嵌入示意图:它有整齐的 token 和 embedding 排列,但本质上不是数据表。
三款工具沿用上一轮真实运行环境:
MacBook Air M2,24 GB 内存,CPU 路径;
Docling 2.120.3;
MinerU 3.4.5;
Marker 2.0.0;
同一批 PDF、同一页范围,原始输出和失败记录全部保留。
这次我没有做逐字符真值,所以不把“识别出多少 table 标签”包装成准确率,而是按实际返工量分四级:
A 级:行列和关键文本正确,可以直接进入 Excel,只需美化;
B 级:主体可用,约 10 分钟内能完成轻量清理;
C 级:虽然识别到了,但结构或文本问题明显,需要较多重整;
D 级:漏检、拆坏、合并错,或者没有形成可用表格。
真正有用的问题不是“它支持表格吗”,而是:粘进 Excel 后,我还要改多久?
第一名不是“全能王”,而是复杂结构上的 MinerU
19 个真实表格中,MinerU 全部检出;13 个达到 A 级,17 个达到 A 或 B。
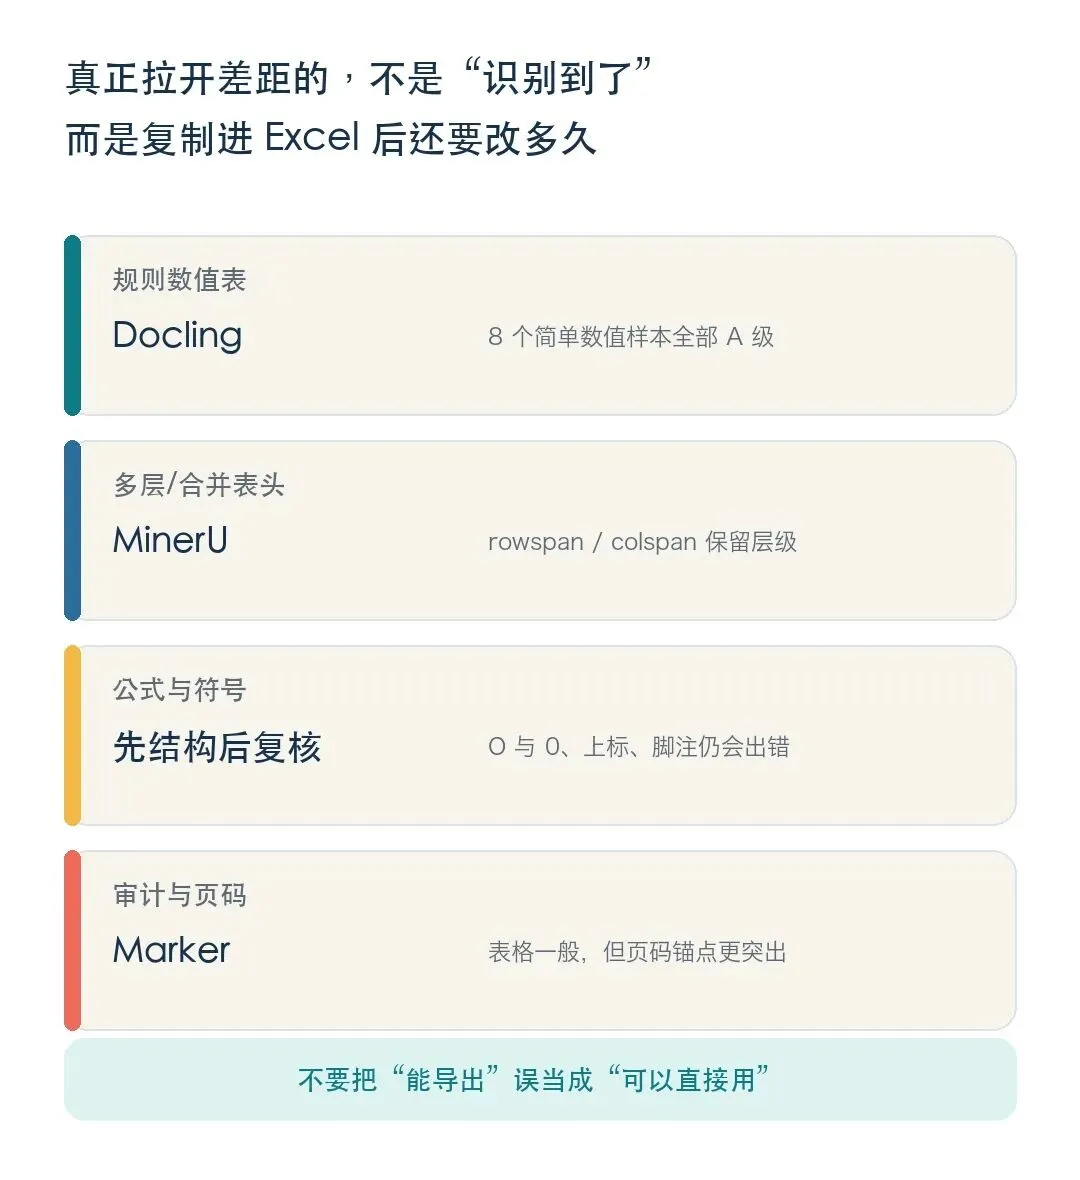
它最明显的优势是愿意用 HTML 的 rowspan 和 colspan 保留多层表头与合并单元格。
例如 Docling Technical Report 的运行性能表,同一个 CPU 下有 4 线程和 16 线程两行,上方又分成 native backend 与 pypdfium backend 两组指标。Docling 自己的默认 Markdown 输出反而把线程值和部分性能数据压进同一个单元格;MinerU 保留了两层表头和跨行 CPU 单元格,后续转二维网格更省力。
Table Transformer 里的过分割结构、规范化结构和宽表也是类似结果:MinerU 的 HTML 看起来没有 Markdown 清爽,但对程序处理更诚实——它没有为了“好看”而轻易抹掉层级。
代价也很明确:HTML 还要再转成二维表;公式、上标和 OCR 字符仍要抽查。Attention 的复杂度表里就出现了 O 与 0 容易混淆的情况。
如果你已经拿到 MinerU 的 HTML 表格,最短的 Excel 导出路径可以是:
import pandas as pdtables = pd.read_html("paper-output.html")for i, table in enumerate(tables, start=1):table.to_excel(f"table-{i:02d}.xlsx", index=False)
这一步解决的是“搬进 Excel”,不是“保证学术正确”。数字、单位、脚注和合并表头仍然要与原页比对。
简单数值表,Docling 反而更舒服
如果把范围缩到规则数值表,结果发生了变化。
我单独看了 8 个典型样本,包括 ResNet 的误差表、Whisper 的模型规格与鲁棒性表、LayoutLMv3 的 mAP 表。Docling 在这 8 个样本里全部达到 A 级。
原因很直接:它输出的 Markdown 表格更规整,模型名、指标名和数字通常保持逐行对应。复制、转 CSV、继续交给 pandas 都比较顺。
但一遇到复杂表头,它会为了扁平化输出而牺牲结构:
ResNet 的网络架构表,多个模型和阶段块被摊成宽表;
Docling 自己的性能表,4/16 线程两行被合并;
Table Transformer 的两层表头,被重复成多个同名列;
两个复杂结构示例和一个算法框没有形成独立表格。
最终 Docling 检出 16/19,9 个 A 级,12 个达到 A 或 B。
这说明 Docling 很适合做第一道快速转换:规则表先走它,遇到合并单元格再路由到 MinerU。
Marker:表格不是第一优势,还要小心误报
Marker 检出 17/19,7 个 A 级,11 个达到 A 或 B。
简单规则表它并不差,ResNet、Whisper 的多张数值表都能直接使用;问题集中在复杂结构:公式里的竖线可能干扰分列,宽表会出现额外空列,两个相邻结构有时被合并成一张表。
更值得注意的是负样本。
BERT 的输入嵌入示意图只是把 token、位置和 embedding 排成整齐的行。Docling 与 MinerU 都没有把它当成数据表;Marker 却输出了一个 12 列 Markdown 表格。
如果后续流程只检查“有没有表格标签”,这种误报会直接进入 Excel 或数据库。表格检测不仅要防漏检,也要防把图、公式和排版结构误当成表。
不过这不等于 Marker 没价值。上一轮 57 页整文解析中,它保留了最明显的页码锚点。做可追溯 RAG 时,这项能力可能比表格更重要;只是这次任务的目标是“提取到 Excel”,它不该排在第一选择。
我会怎么搭一条真正可用的流水线
如果目标是批量处理论文,而不是偶尔复制一张表,我不会把全部 PDF 交给单一工具。
第一步:先判断页面里是不是真的有表
同时看视觉区域与文本结构。遇到 BERT 输入示意图这类“规则排列但不是数据表”的内容,不要只相信 table 标签。
第二步:规则数值表先走 Docling
输出是规则 Markdown 网格、列数稳定、每行单元格数一致,就直接进入 CSV/Excel 转换。
第三步:检测到合并结构就切 MinerU
只要出现两层表头、跨行/跨列、分组列、投影行标题或算法框,就优先保留 HTML 的 rowspan / colspan,再展开成二维网格。
第四步:导出前做四项自动检查
1. 每行列数是否一致;
2. 数值列里是否混入整段文本;
3. 表头是否出现大量重复空列;
4. 字符核对:`O/0`、`l/1`、负号、百分号、上标和脚注是否异常。
第五步:把原页和坐标一起保存
至少保留 document_id + page + bbox + parser_version。重要数字一旦有争议,可以立刻回到原 PDF,而不是在三个中间文件里猜。
最后给一个直接选择
只想处理普通论文数值表:先装 Docling。
经常处理复杂表头、财务表、实验设置表:先装 MinerU。
核心任务是带页码追溯的论文知识库:再考虑 Marker,表格单独路由。
真正重要的数据:三款都不能替你承担最后一次人工核对。
这次横测最想纠正的误区就是:不要把“能导出”误当成“可以直接用”。表格工具的价值,不在于生成一个文件,而在于减少多少可靠的人工返工。
下一篇我准备把这条流程做成一个可以直接运行的“PDF 表格批量转 Excel”小工具:你更希望它优先支持 中文学位论文,还是 英文科研论文?
参考资料
01 Docling 官方仓库
github.com/docling-project/docling
02 MinerU 官方仓库
github.com/opendatalab/MinerU
03 Marker 官方仓库
github.com/datalab-to/marker
04 Attention Is All You Need
arxiv.org/abs/1706.03762
05 Table Transformer / PubTables-1M
arxiv.org/abs/2110.00061
06 Docling Technical Report
arxiv.org/abs/2408.09869

