我把PPT和HTML页面交给AI,它却“假装”听懂了
- 2026-09-24 07:33:38
昨天我做了一件自以为很聪明的事。
把手头一份 PPT,连同需要改的网页内容和 HTML 页面,一股脑交给 WorkBuddy,下了指令:“按这个 PPT 的内容,把网页改一改,尤其是移动端的视频和样式。”
我满心期待地等结果。
然后发现:PPT 像从没被打开过,HTML 的样式改动几乎看不见,移动端那个视频,该播不了还是播不了。
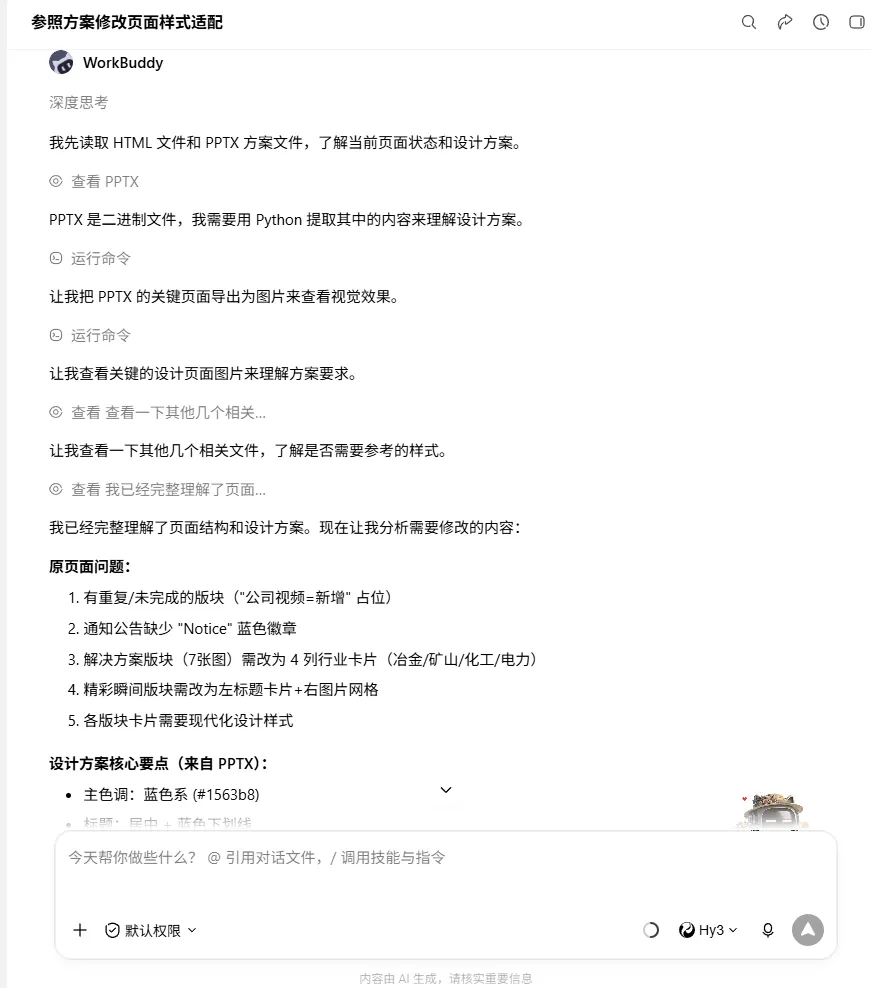
那一刻我忍不住想:WorkBuddy 是不是根本理解不了 PPT?
一、先给结论:它能,只是有前提
查了一圈资料和官方说明,答案其实很清楚:WorkBuddy 完全具备处理 PPT 的能力。它内置了 pptx 技能,可以做演示文稿的创建与编辑;桌面端还有“人机双写”模式,能直接在 PPT、Word、Excel 的画布里协同修改;技能商店里也有第三方 PPT 技能,套上模板后视觉质感会好一大截。
但问题恰恰出在“前提”上。一篇亲测文章说得很直白:同一份 PPT,“简单描述直出”和“用了工作流/模板”的结果,差了不止一个档次。也就是说,能力在,但用法不对,效果就会“假”得明显。
二、为什么你的修改“没效果”?三个真相
真相 1:AI 是个“盲人”,看不见渲染结果
传统大模型写前端,本质是“盲打”。它能写出语法正确的代码,却看不见代码跑起来长什么样。你让它“把按钮往左移 5 像素、颜色深一点”,它改完你一跑,又歪了。这种“文本指令—代码输出—人肉验收—再描述”的循环,效率极低。
所以当你说“改改样式”,如果 AI 没有真正渲染并查看你的 HTML,它给出的往往是一段“看起来对”的代码,而不是“看起来对且真的生效”的改动。
真相 2:碎片化生成,缺了全局结构
前端大模型应用有个普遍困境:擅长分段实现局部功能,但代码不够整体化。当你同时丢进 PPT + HTML + 一堆要求,AI 容易“东改一点西改一点”,缺乏全局一致性,最后互相冲突、多处失效。一篇行业分享里提到,即便上下文窗口扩到百万级,AI 仍难真正理解项目的“完整图景”。
真相 3:移动端视频,是连人类工程师都头疼的硬骨头
这点最容易被忽略。你以为“改个视频”是小事,但移动端(尤其 iOS)的视频播放,本来就是前端的“老大难”:
MP4 的 MOOV 元数据如果放在文件末尾,iOS Safari 会加载缓慢、拖拽失败;
iOS 对 H.264 的 Profile / Level 有严格限制,级别过高直接黑屏;
不同浏览器、不同系统对编码格式(VP9 / AV1 / H.265)的支持参差不齐。
换句话说,哪怕是一个资深前端,遇到移动端视频事故也得用 ffmpeg 仔细排查。让 AI“顺手改好”,本就是个高难度期望。
三、怎么让 AI 真正“听懂”?4 条实战建议
- 别“一句话直出”,用模板和工作流。
给 PPT 任务时,先选内置模板或挂载 PPT 技能,再把要求一起发。同样的模型,套了模板的成品“AI 味”会淡很多。
- 用“人机双写”,在文件里直接改。
选中 HTML 里要改的区域,让 AI 直接在原文件指定位置修改,而不是返回一段新文本让你自己替换——格式不丢、上下文不偏。
- 把需求切碎,给视觉参照。
与其说“整体优化”,不如说“把第 3 屏视频容器的圆角改成 12px、封面图右移 20px”。最好附一张期望效果的截图或参考链接。
- 移动端视频,把技术参数写死。
直接告诉 AI:“用 ffmpeg 把视频转成 H.264 High Profile Level 4.1、加 -movflags faststart”,比笼统说“让视频能播”靠谱得多。
四、结语:AI 是副驾,不是司机
回到最初的问题——WorkBuddy 理解不了 PPT 吗?能。但它不是你脑子里那个“一看就懂”的同事。它更像一位手快但看不见屏幕的实习生:你给的上下文越清晰、约束越具体、校样越及时,它的产出越接近预期。
那次“毫无效果”的失败,与其说是工具的缺陷,不如说是一场“期望错位”。把 PPT 和 HTML 一股脑扔过去,指望它自己悟透,是目前任何 AI 都还做不到的事。
真正好用的姿势,是人机接力:你想清楚要什么,它负责把繁琐的执行跑完。

