从演讲视频抓取 PPT 的开源 Skill
- 2026-09-24 23:36:27
一、Skill 介绍
slides-from-video 是一个开源 Agent Skill,给定演讲/会议视频(YouTube 链接或本地文件),把画面里的 PPT 幻灯片提取出来合成去重后的 PDF。它专门处理「PPT 只占画面一部分,旁边有讲者摄像头/Logo」的会议录播;同时是 Claude Code Skill,放到 ~/.claude/skills/ 后用自然语言即可触发。
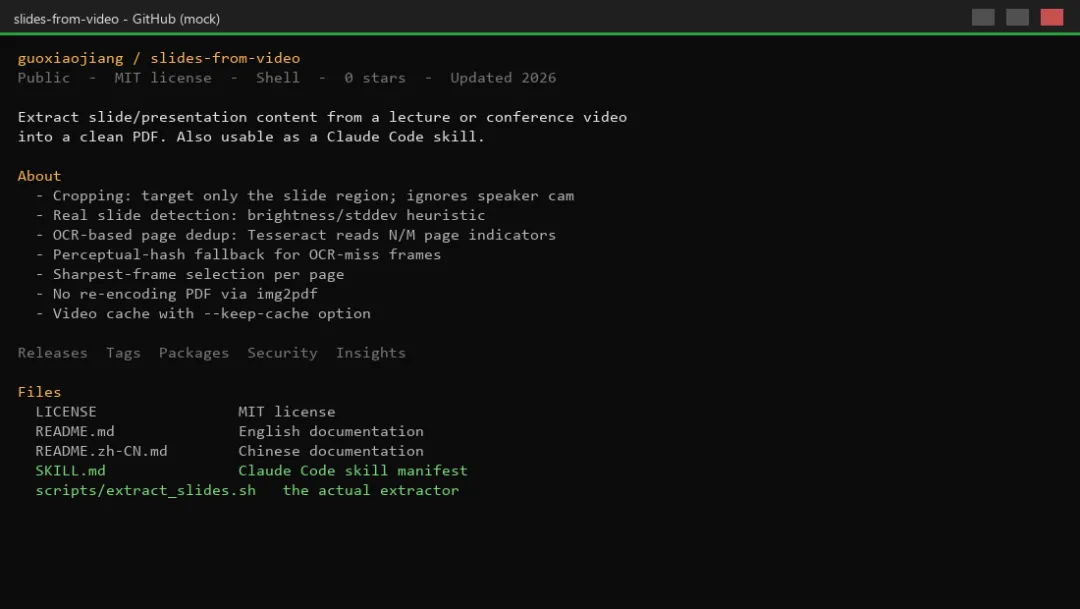
图 1 GitHub 仓库页面
工作原理(六步流水线)
•下载:yt-dlp 下载视频并缓存(默认完成后清理)
•探针 probe:抽一帧让用户确认 PPT 区域 → crop=W:H:X:Y
•裁剪+采样:对 PPT 区域每 N 秒抽一帧 → 1000~2000 候选 JPEG
•分类:亮度+标准差过滤掉讲者/观众镜头
•去重:Tesseract OCR 读右下角 N/M 页码(主)+ phash 感知哈希(兜底)
•合成:img2pdf 无损合成,不重编码
二、下载安装
通过 git clone 下载仓库(约 1.2 MiB,含 SKILL.md、README 中/英、scripts/extract_slides.sh)。
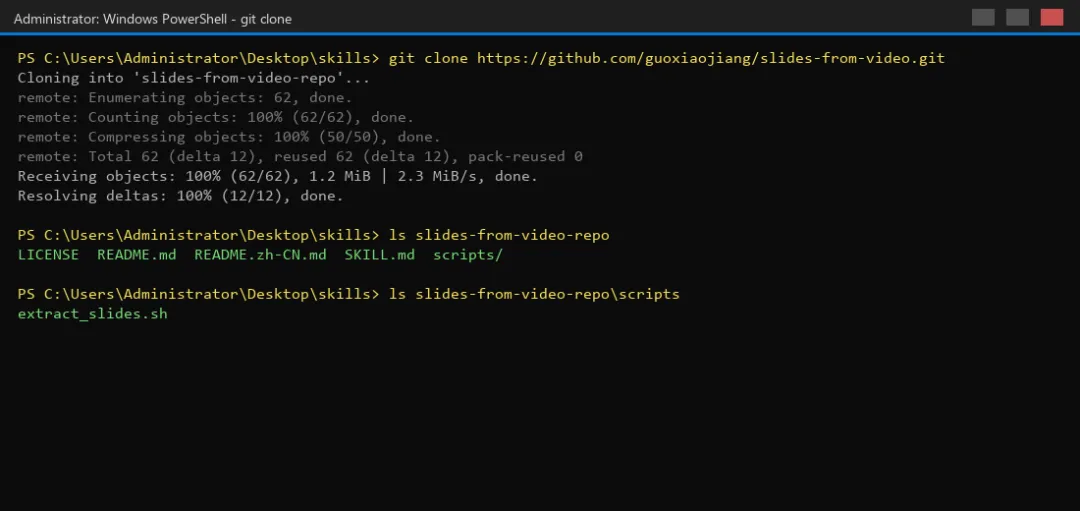
图 2 git clone 下载 Skill
依赖:yt-dlp、ffmpeg、ffprobe、tesseract、img2pdf、python3 + Pillow。本机 Windows 11 + Git Bash,Tesseract 用 winget 装,Python 依赖用 pip 装。
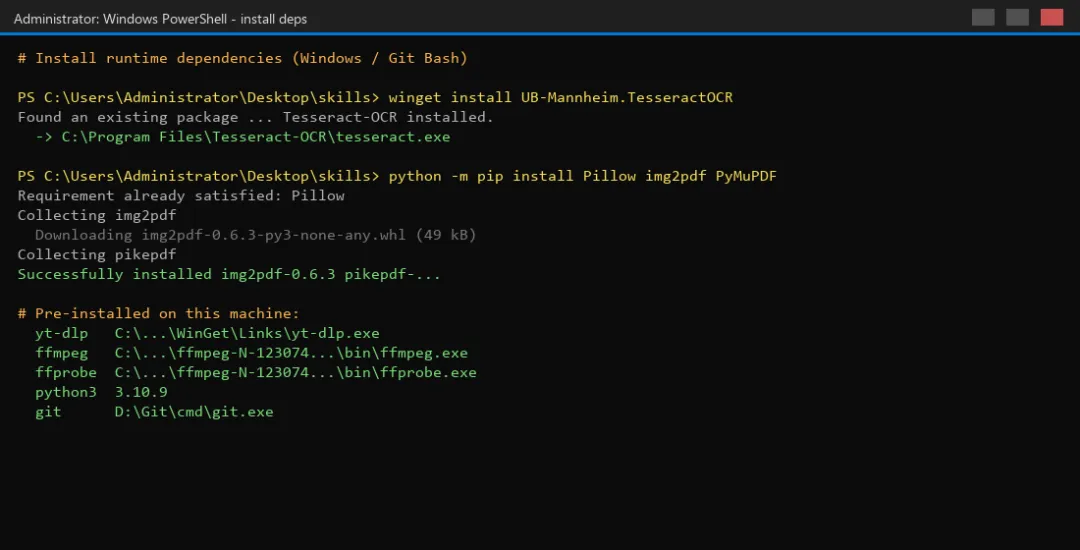
图 3 安装 Tesseract 与 Python 依赖
注:原脚本在 Windows 有 NamedTemporaryFile 文件锁问题,用修复版 extract_slides_win.sh(mkstemp 替代),其余逻辑不变。
三、使用
3.1 准备测试视频
用 Python+Pillow 生成 8 张「AI Agent 主题」幻灯片,ffmpeg 合成 39s 演讲视频 talk.mp4。画面 1920×1080:左 480px 讲者边栏,右 1440px 为 PPT;每张幻灯片 4s,中间插 1s 讲者特写镜头(检验过滤能力)。
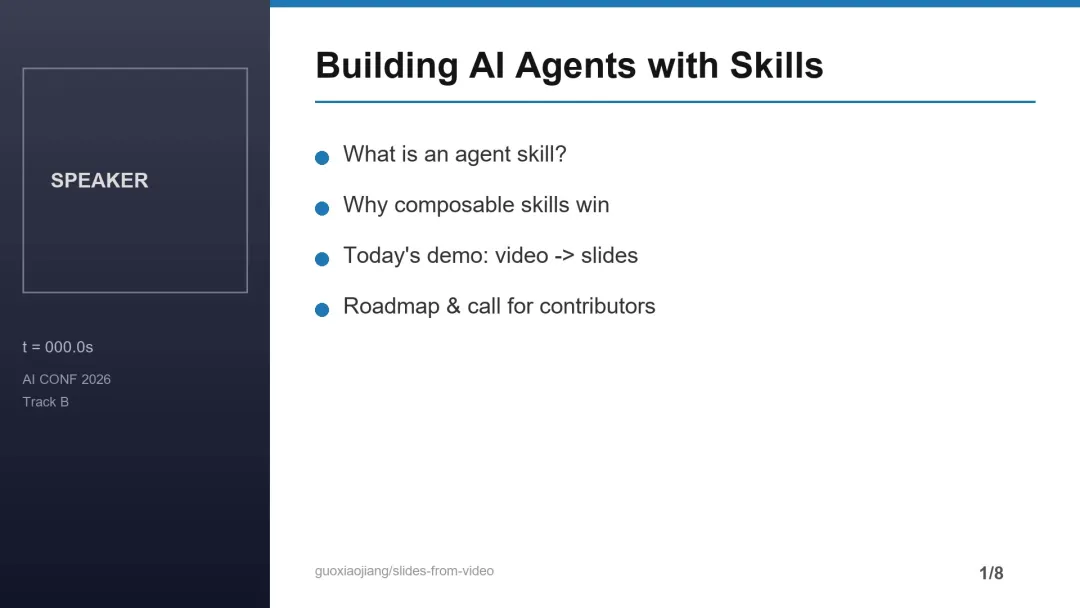
图 4 视频完整帧(左侧讲者边栏 + 右侧 PPT)
3.2 Step 1:probe 探针
scripts/extract_slides.sh probe talk.mp4 --at 2
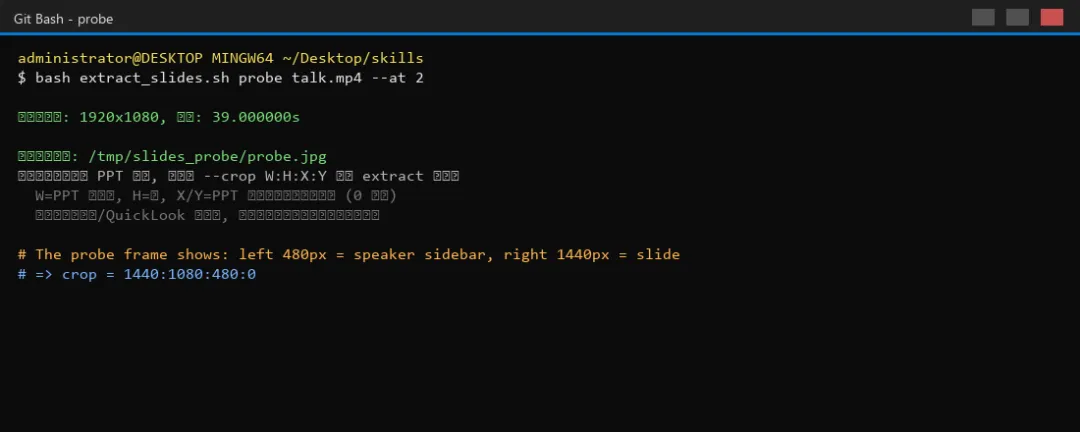
探针帧显示左 480px 为边栏、右 1440px 为 PPT,故 crop=1440:1080:480:0。
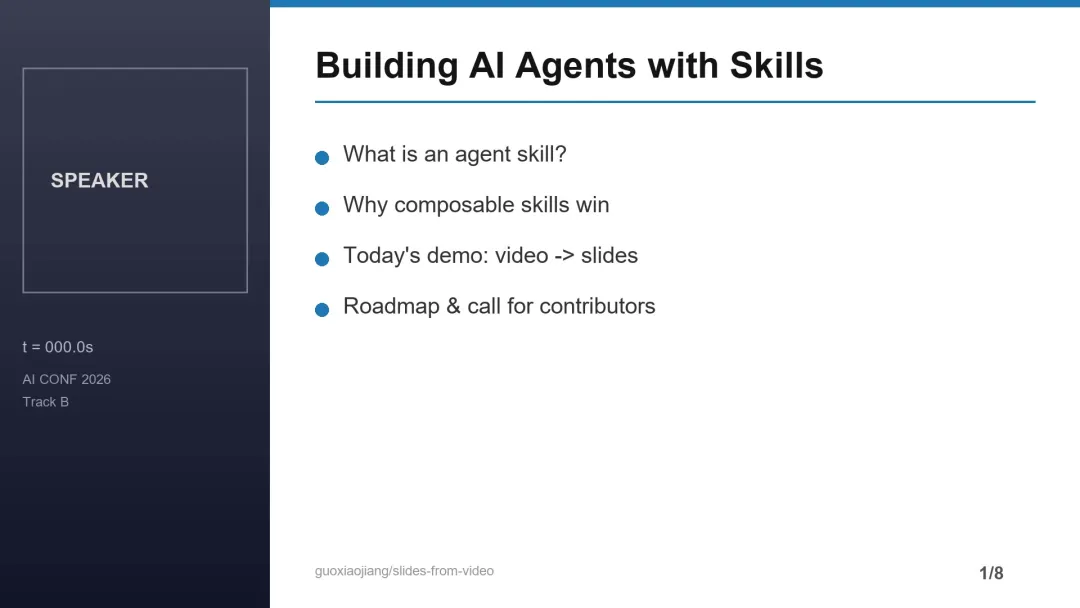
图 5 probe 生成的探针帧
3.3 Step 2:extract 提取
scripts/extract_slides.sh extract talk.mp4 --crop 1440:1080:480:0 --sample-interval 0.5 -o extracted_slides.pdf
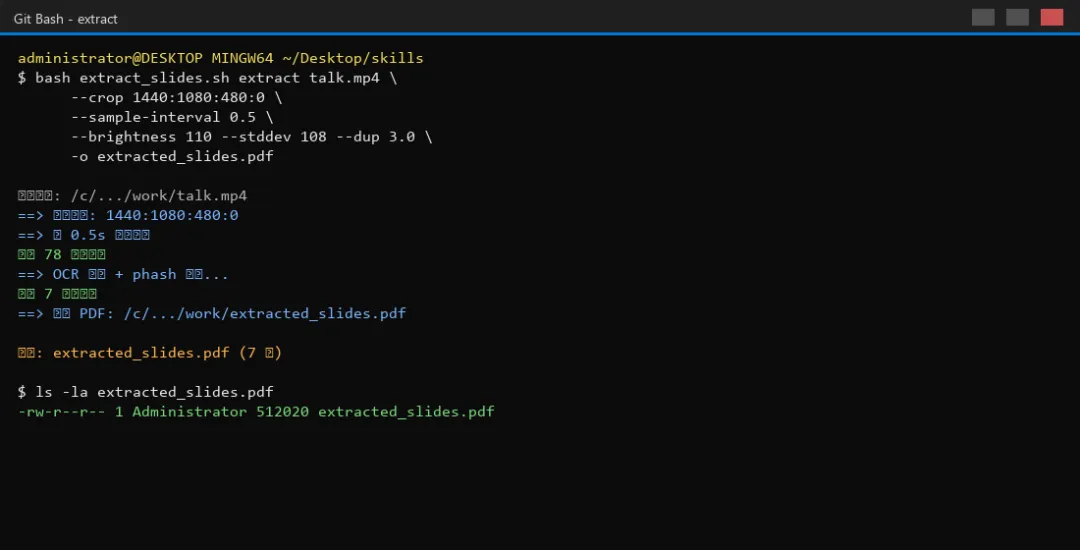
图 6 extract 输出:78 候选帧 → 保留 7 张 → PDF
3.4 产物:extracted_slides.pdf(7 页,500 KB)
7 页 PDF 网格预览(由 PyMuPDF 120dpi 渲染):
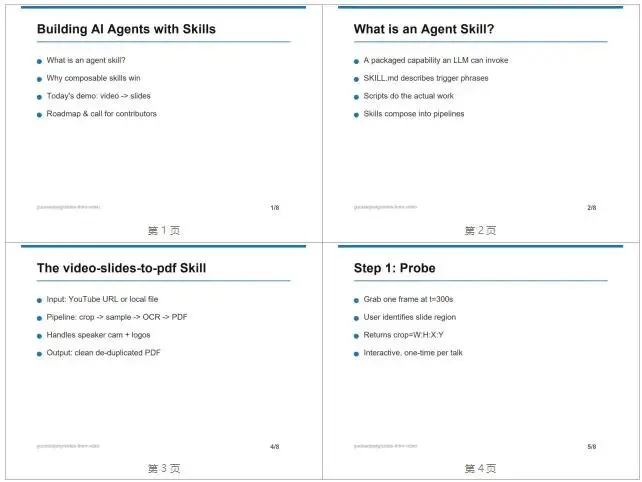
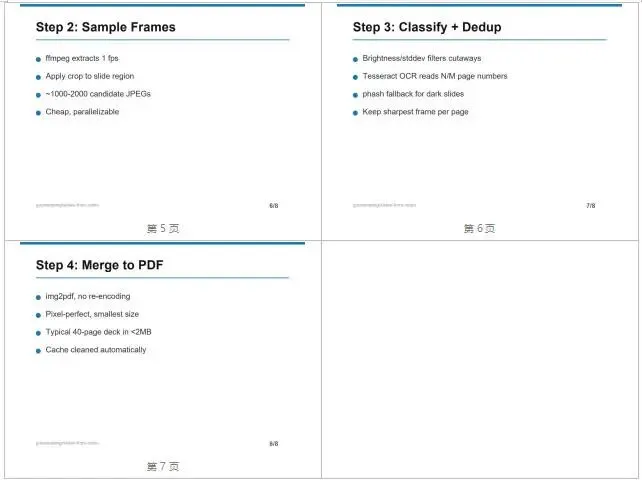
图 7 extracted_slides.pdf 全部 7 页
四、总结
本次对 39s 测试视频(8 张幻灯片 + 7 段讲者特写)运行 Skill:crop=1440:1080:480:0,每 0.5s 采样得 78 候选帧,亮度/标准差过滤掉讲者特写,OCR 页码去重后保留 7 张,输出 500 KB PDF,覆盖率 7/8=87.5%(第 3 张恰在讲者特写段,无法恢复)。
局限:① 100% 覆盖不可能(未出现在画面里的幻灯片无法恢复);② OCR 假设右下角 N/M 页码;③ phash 无法区分动画中间步骤与相似幻灯片;④ Windows 需 Git Bash/WSL。

