020.词元和高质量数据集是什么关系?ppt图文解读
- 2026-09-23 05:42:04
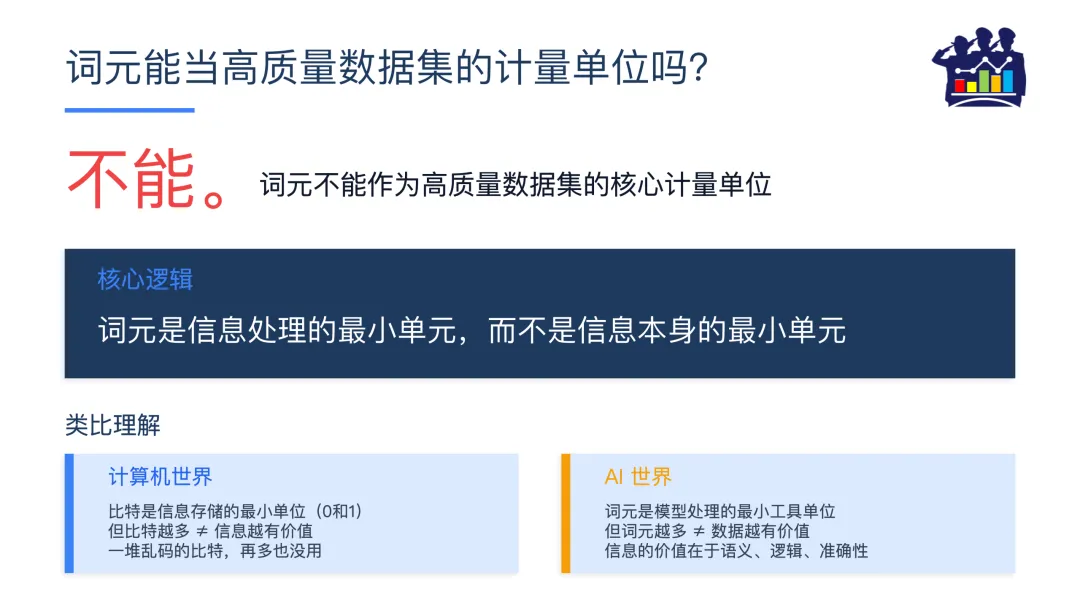
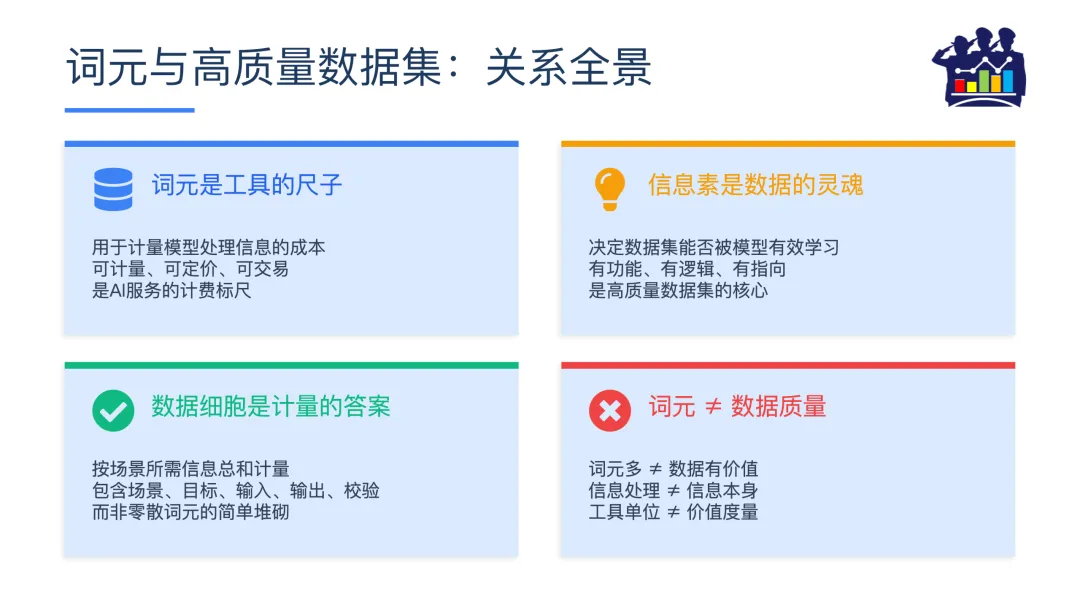
高质量数据集最大的痛点,就是长期以来没有统一、科学的计量单位。但词元还是不能作为高质量数据集的核心计量单位。有一个底层逻辑必须明白:词元是信息处理的最小单元,而不是信息本身的最小单元,这个区别至关重要。
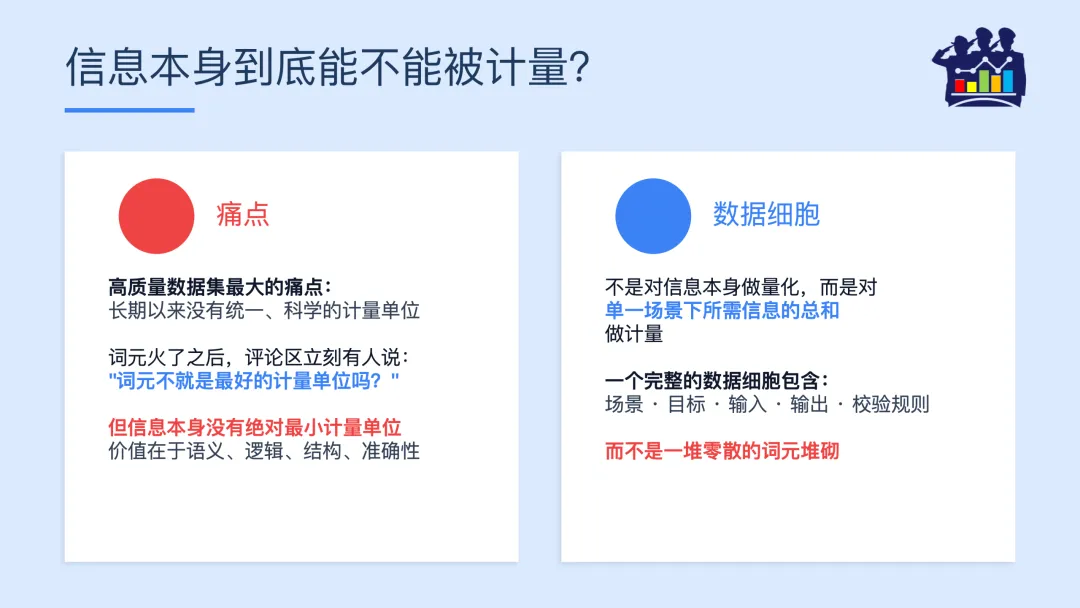
词元是模型“干活”时用的最小工具单位,负责处理信息,但信息本身有没有价值、准不准确、逻不清晰、有没有用,词元根本衡量不了,信息本身是没有绝对最小计量单位的,它的价值在于语义、逻辑、结构、准确性,而不是被拆分成多少个词元。
2、信息本身到底能不能被计量?
所谓数据细胞,并不是对信息本身做量化,而是对单一场景下所需信息的总和做计量,一个完整的数据细胞,应该包含场景、目标、输入、输出、校验规则等全套要素,而不是一堆零散的词元堆砌,这就从根本上否定了“词元=数据集质量”的简单逻辑,也为我自己思考高质量数据集建设,打开了全新的思路。
3、什么样的数据集能满足模型的需求?
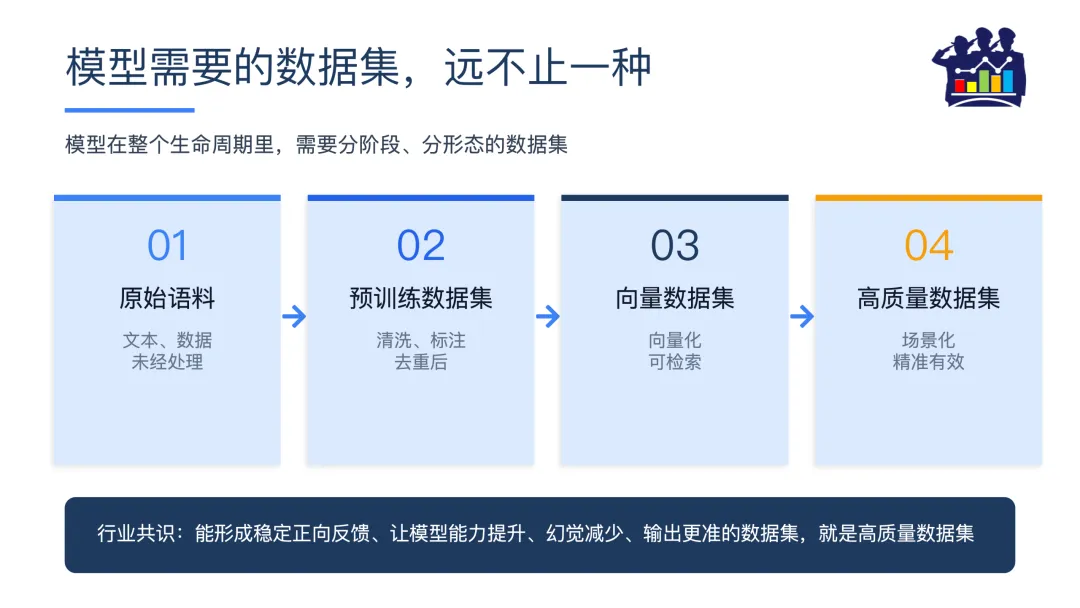
目前行业里有一个相对共识的标准:只要把一个数据集投喂给大模型,能形成稳定、持续的正向反馈,让模型能力提升、幻觉减少、输出更准,那它就是高质量数据集。这个标准很务实,但不够具体,我们要做的,就是顺着模型的真实需求,把建设思路拆解开。
模型在整个生命周期里,需要的数据集根本不是一种,而是分阶段、分形态的——从最原始语料、文本、数据,到清洗、标注、去重后的预训练数据集,再到向量化、可检索的向量数据集,最后形成高质量数据集,每一个阶段形态不同,但核心需求是统一的。
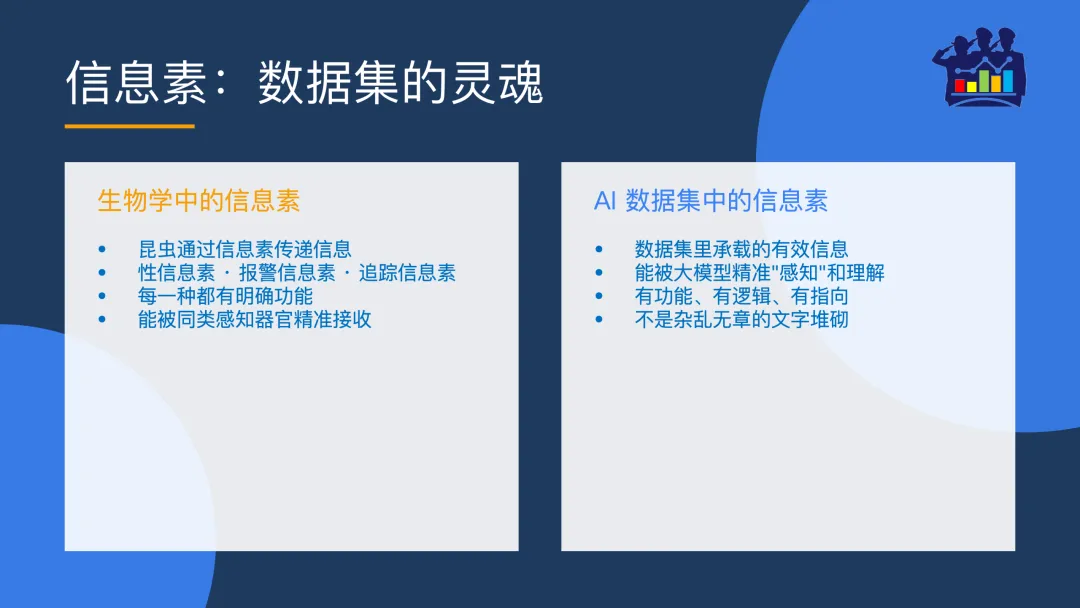
在AI数据集里,信息素就是数据集里承载的、能被大模型精准“感知”和“理解”的有效信息,它不是杂乱无章的文字堆砌,而是有功能、有逻辑、有指向的信息集合,大模型就像那个接收信息素的主体,只有数据集里的信息素足够清晰、准确、有效,模型才能真正读懂、学会、用好,否则再多词元都是无效输入。
4、小结:
词元是模型处理信息的“尺子”,不是衡量数据价值的“秤”;信息素是数据的灵魂,决定模型能否真正学会用好;“数据细胞”按场景计量信息总和,是高质量数据集的答案。