LangChain 学习笔记(三):提示词模板与输出解析
- 2026-11-15 08:19:36
一、提示词模板(Prompts)
什么是提示词模板
在大模型应用开发中,我们通常需要根据不同的用户输入来构造不同的Prompt。如果每次都手动拼接字符串,不仅代码冗余,还容易出错。提示词模板(Prompt Template)的核心思想是将Prompt中的固定部分与可变部分分离,通过定义模板 + 传入变量的方式,动态生成最终的Prompt。
核心价值:
提示词模板类型概览
LangChain围绕不同的使用场景,提供了多种提示模板类型。在学习具体类型之前,先从全局视角了解它们的定位:
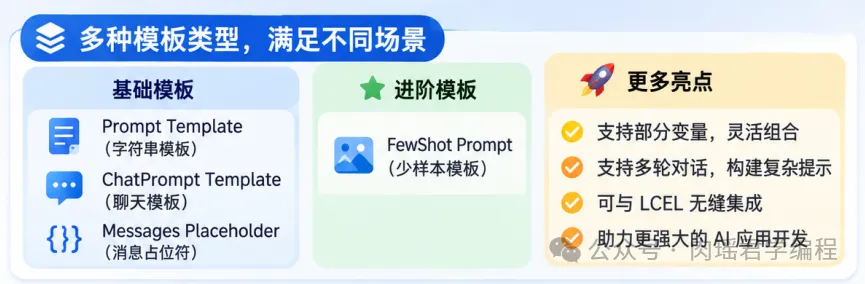
Prompt Template 字符串模板
ChatPrompt Template 聊天模板
Messages Placeholder 消息占位符
FewShot Prompt 少样本模板
提示词模板工作原理
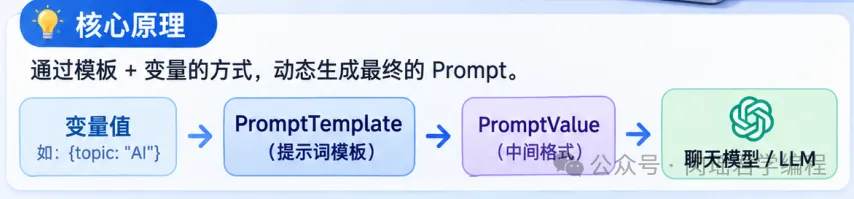
在深入各类模板之前,先理解它们的统一工作原理。所有提示词模板都遵循相同的处理流程:
变量值 → PromptTemplate → PromptValue → 聊天模型 / LLM工作流程:
输入:传入变量值(通常以字典形式,如 {"topic": "AI"};若变量已通过partial预先填充,可不传)格式化:模板将变量值插入到预定义的占位符位置 输出:生成 PromptValue对象(一种中间格式)调用: PromptValue可以自动适配聊天模型(转为消息列表)或LLM(转为字符串)
这种统一的输入输出机制,使得所有模板都可以在LCEL链中无缝使用。
PromptTemplate
这是最基础的提示词模板类型,适用于简单的文本生成场景——即字符串提示模板。它接收一个包含占位符的字符串模板,通过传入变量值来生成最终的 Prompt 。
from langchain_core.prompts import PromptTemplate# 方式一:使用from_templateprompt1 = PromptTemplate.from_template("讲一个关于{topic}的{adjective}故事")# 方式二:使用构造方法prompt2 = PromptTemplate(template="讲一个关于{topic}的{adjective}故事", input_variables=["topic", "adjective"])# 调用模板formatted_prompt1 = prompt1.invoke({"topic": "广东话", "adjective": "搞笑的"})print(formatted_prompt1)formatted_prompt2 = prompt2.invoke({"topic": "广东话", "adjective": "搞笑的"})print(formatted_prompt2)
我们发现这里也有invoke 方法,几乎所有的 langchain 组件都实现了 Runnable 接口,所以都可以调用该接口提供的统一标准方法。
模型实例对象组件 提示词模板对象组件 记忆对象组件 Chains 对象组件 工具对象组件 Agent 对象组件
Key Methods===========- `invoke`/`ainvoke`: Transforms a single input into an output.- `batch`/`abatch`: Efficiently transforms multiple inputs into outputs.- `stream`/`astream`: Streams output from a single input as it's produced.- `astream_log`: Streams output and selected intermediate results from an input.
当模板中有些变量的值是固定的或可以提前确定时,可以使用 partial 机制预先填充部分变量,减少后续调用时需要传入的参数数量。
from langchain_core.prompts import PromptTemplate# 方式一:使用from_templateprompt1 = PromptTemplate.from_template("讲一个关于{topic}的{adjective}故事")fixed_prompt_1 = prompt1.partial(adjective="有趣的")print(fixed_prompt_1.invoke({"topic": "编程"}))# 方式二:使用构造方法prompt2 = PromptTemplate(template="请解释{concept},使用{style}风格", input_variables=["concept"],partial_variables={"style": "简单易懂"})print(prompt2.invoke({"concept": "递归"}))
如何选择?
优先用
partial():当“固定值”是在运行时才确定,或需要分阶段逐步补全时
例:来自配置文件/环境变量/用户选择后再固定;或先固定 style,后续再固定 adjective。
优点:更灵活,适合链式构建与复用同一个基础模板。
优先用
partial_variables:当“固定值”在定义模板时就确定,且希望模板对象一创建就自带默认常量时
例:文档里明确规定“统一用简单易懂风格”;团队约定的固定前缀/固定语气。
优点:模板更“自描述”,一眼能看出哪些变量是固定的,适合沉淀为通用模板。
简单决策表
固定值 是否依赖运行时上下文:是 →
partial();否 →partial_variables是否需要 多次派生不同版本(同一模板固定不同值):是 →
partial()更方便是否想把“默认值/常量”写死在模板定义处:是 →
partial_variables
ChatPromptTemplate
PromptTemplate 生成的是一个纯字符串Prompt,而在多轮对话场景中,大模型需要接收的是消息列表(包含角色信息的多条消息)。ChatPromptTemplate——即聊天提示模板——正是为此设计的,它可以构建包含 system、human、ai 等不同角色的消息序列。
from langchain_core.prompts import ChatPromptTemplate# 使用from_messages构造(推荐)chat_prompt = ChatPromptTemplate.from_messages([("system", "你是一个专业的{role}。"),("human", "请回到我关于{topic}的问题。"),("ai", "好的,我会尽力回答。"),("human", "question")])# 调用模板,生成消息列表messages = chat_prompt.invoke({"role": "Python编程助手","topic": "Python装饰器","question": "什么是装饰器?"})print(messages)
其中,元组的第一个元素是角色标识,第二个元素是消息内容模板。LangChain支持的角色标识包括:
"system" | SystemMessage | |
"human" | HumanMessage | |
"ai" | AIMessage |
除了元组形式,也可以直接使用Message对象来构造模板。两种方式可以混合使用:
from langchain_core.messages import HumanMessage, SystemMessage, AIMessagechat_prompt = ChatPromptTemplate.from_messages([SystemMessage(content="你是一个专业的Python编程助手。"), # 固定内容HumanMessage(content="请回到我关于Python装饰器的问题。"), # 固定内容AIMessage(content="好的,我会尽力回答。"), # 固定内容("human", "question") # 含变量的用元组形式])messages = chat_prompt.invoke({"question": "什么是装饰器?"})print(messages)
选择建议:如果消息内容是固定的(不包含变量),用 Message 对象更直观;如果内容包含需要填充的变量,用元组形式更简洁。
MessagesPlaceholder
在实际的对话应用中,我们往往需要将历史对话记录动态插入到Prompt中。MessagesPlaceholder 允许你在模板中预留一个"插槽",运行时将一个消息列表整体插入到该位置。
这在构建带记忆的对话系统时尤为常用。
MessagesPlaceholder ----> BaseMessagePromptTemplatePromptTemplate -----> StringPromptTemplate ----> BasePromptTemplateChatPromptTemplate ----> BaseChatPromptTemplate ----> BasePromptTemplate
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholderfrom langchain_core.messages import HumanMessage, AIMessageprompt = ChatPromptTemplate.from_messages([("system", "你是AI助手"),MessagesPlaceholder(variable_name="history"),("human", "{input}")])messages = prompt.invoke({"history": [HumanMessage(content="什么是Python?"),AIMessage(content="Python是一种通用编程语言。"),],"input": "它有什么特点?"})print(messages)
注意:history 变量在格式化的时候一定是一个列表类型
也可以使用更简洁的元组语法实现同样的效果:
# 等价写法,使用("placeholder", ...)语法prompt2 = ChatPromptTemplate.from_messages([("system", "你是AI助手"),("placeholder", "{history}"),("human", "{input}")])messages = prompt2.invoke({"history": [("human", "什么是Python?"),("ai", "Python是一种通用编程语言。"),],"input": "它有什么特点?"})print(messages)
FewShotPromptTemplate
前面介绍的模板解决了"如何动态构建Prompt"的问题。但在实际应用中,我们经常需要通过提供示例来引导模型理解任务模式——这就是少样本提示模板。FewShotPromptTemplate 将示例数据和格式化模板组合在一起,自动生成包含示例的完整Prompt。
生成的Prompt结构为:prefix + 示例1 + 示例2 + ... + suffix。
from langchain_core.prompts import FewShotPromptTemplate, PromptTemplate# 第一步:准备示例数据examples = [{"input": "高兴", "output": "开心"},{"input": "难过", "output": "悲伤"},{"input": "生气", "output": "愤怒"}]# 第二步:定义单条示例的格式化模板example_formatter = PromptTemplate(template="输入: {input}\n输出: {output}",input_variables=["input", "output"])# 第三步:创建少样本提示模板few_shot_prompt = FewShotPromptTemplate(examples=examples,example_prompt=example_formatter,prefix="以下是一些同义词转换的例子:", # 示例前的说明文字suffix="\n输入: {input}\n输出:", # 示例后的实际问题input_variables=["input"])# 调用message = few_shot_prompt.invoke({"input": "兴奋"})print(message)
提示词模板最佳实践
FewShotPromptTemplate | ||
小结:第一节介绍了LangChain提供的各类提示词模板。从简单的
PromptTemplate(字符串模板)到ChatPromptTemplate(聊天模板),再到FewShotPromptTemplate(少样本模板)它们解决的核心问题是如何灵活、可维护地构建Prompt。有了结构化的Prompt之后,下一个问题自然是:模型返回的结果如何解析为我们需要的结构化数据?这就是第二节要讨论的输出解析器。
二、输出解析器(Output Parsers)
为什么需要输出解析器
在对话场景中,大模型直接返回自然语言文本即可。但在实际生产环境中,我们通常需要将大模型用于非对话场景(如数据提取、内容生成流水线等),此时需要模型以结构化的格式(如JSON、列表)输出结果,以便程序进一步处理。
LangChain在 langchain_core.output_parsers 包中提供了一系列输出解析器,专门解决"如何将模型的自然语言输出转换为结构化数据"这一问题。
要让大模型输出结构化数据,有两种基本策略:
下面分别介绍这两种策略的具体实现。
策略一:通过Prompt约束(JsonOutputParser)
JsonOutputParser 的工作原理是:将你定义的JSON Schema转化为一段格式说明文字,插入到Prompt中,引导模型按照指定结构输出JSON。
使用步骤:
通过Pydantic定义目标JSON结构 构造 JsonOutputParser实例调用 get_format_instructions()获取格式说明,插入到Prompt中调用模型并用解析器解析结果
from langchain_core.output_parsers import JsonOutputParserfrom pydantic import BaseModel, Fieldfrom langchain_ollama import ChatOllamallm = ChatOllama(model="qwen3:8b", base_url="http://localhost:11434")# 1. 定义目标JSON 结构class Prime(BaseModel):prime: list[int] = Field(description="素数")count: list[int] = Field(description="小于该素数的素数个数")# 2. 构造解析器json_parser = JsonOutputParser(pydantic_object=Prime)# 3. 将格式说明放入SystemMessagesystem_message = json_parser.get_format_instructions()print(system_message) #res = llm.invoke([("system", system_message),("human", "任意生成5个1000-100000之间的素数,并标出小于该素数的素数个数")])print(res.content)# 4. 解析为Python字典parsed_res = json_parser.invoke(res)print(type(parsed_res)) # <class 'dict'>print(parsed_res)
JsonOutputParser 如果没有参数的话,get_format_instructions 返回的内容为 Return a JSON object.
Pydantic 是 Python 里做数据校验和设置管理的库,核心是用类型注解来定义数据结构,运行时自动帮你校验、转换和序列化数据。简单来说,你可以用它定义一个数据模型类,Pydantic 会确保传入的数据符合你定义的结构和类型。
from pydantic import BaseModel, Field# 定义一个数据模型class User(BaseModel):name: str # 名字必须是字符串age: int # 年龄必须是整数email: str = Field(description="用户的邮箱地址")# 创建实例 - 数据会自动校验和转换user = User(name="张三", age=25, email="zhangsan@example.com")print(user.name) # 张三print(user.age) # 25# 类型不匹配时,Pydantic会自动尝试转换user2 = User(name="李四", age="30") # age是字符串"30",会自动转为整数30print(user2.age) # 30 (已自动转换为int)# 数据不合法时会抛出错误# User(name="王五", age="abc") # 报错:无法将"abc"转为整数
Pydantic的核心价值:
类型安全:自动校验数据类型 自动转换:能转换的类型会自动处理(如字符串"30" → 整数30) 清晰的错误提示:校验失败时给出详细的错误信息 JSON支持:可以轻松与JSON数据互相转换
策略二:通过厂商原生能力
主流大模型厂商的API已经提供了专门的参数,在API层面强制模型输出符合指定Schema的结构化数据,比Prompt约束更加可靠。
OpenAI示例:
from openai import OpenAIfrom pydantic import BaseModelclient = OpenAI()class CalendarEvent(BaseModel):name: strdate: strparticipants: list[str]response = client.chat.completions.parse(model="gpt-4o-mini",messages=[{"role": "user", "content": "Alice and Bob are going to a science fair on Friday."}],response_format=CalendarEvent)print(response.choices[0].message.parsed)# CalendarEvent(name='Science Fair', date='Friday', participants=['Alice', 'Bob'])
注意:它不是给模型输入的参数,而是告诉 API:把模型生成的内容按你提供的结构(这里是CalendarEvent这个Pydantic模型)进行约束/引导生成 + 结果解析与校验,并把解析后的对象放到 response.choices[0].message.parsed。
输入阶段仍然是 messages; response_format 影响的是模型该如何组织输出
LangChain统一封装:with_structured_output
LangChain提供了 with_structured_output() 方法,将不同厂商的结构化输出能力统一到同一个接口下。无论底层使用哪家模型,调用方式完全一致:
from dotenv import load_dotenvfrom langchain_deepseek import ChatDeepSeekfrom pydantic import BaseModel# 1. 初始化LLMload_dotenv()llm = ChatDeepSeek(model_name="deepseek-flash", temperature=0,extra_body={"thinking": {"type": "disabled"}}, # 关键:关思考)# 2. 定义Pydantic模型class CalendarEvent(BaseModel):name: strdate: strparticipants: list[str]# 3. 使用with_structured_output,返回一个新的Runnablestructured_llm = llm.with_structured_output(schema=CalendarEvent)# 4. 调用,直接返回Pydantic对象result = structured_llm.invoke("Alice and Bob are going to a science fair on Friday.")print(result) # CalendarEvent(name='Science Fair', date='Friday', participants=['Alice', 'Bob'])print(type(result)) # <class 'CalendarEvent'>
DeepSeek 官方文档:thinking 模式默认开,结构化输出/工具调用前先关掉。
核心优势:如果后续需要更换模型(如从OpenAI切换到Anthropic),只需修改LLM的初始化代码,with_structured_output 的调用方式无需任何改动。
其他常用输出解析器
除了JSON解析,LangChain还提供了多种面向不同数据格式的输出解析器。
https://reference.langchain.com/python/langchain-core/output-parsers
最简单的解析器,将模型输出的 AIMessage 对象提取为纯字符串。它是构建链时最常用的解析器:
from langchain_core.output_parsers import StrOutputParserparser = StrOutputParser()# 通常在LCEL链中使用:chain = prompt | llm | StrOutputParser()
它让大模型输出符合Pydantic模型定义的结构化数据,并返回经过校验的Pydantic对象实例。
与 JsonOutputParser 返回普通字典不同,PydanticOutputParser 返回的是Pydantic对象,因此支持字段级别的校验规则:
from dotenv import load_dotenvfrom langchain_core.output_parsers import PydanticOutputParserfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_deepseek import ChatDeepSeekfrom pydantic import BaseModel, Field, field_validator# 1. 初始化LLMload_dotenv()llm = ChatDeepSeek(model_name="deepseek-flash", temperature=0,extra_body={"thinking": {"type": "disabled"}}, # 关键:关思考)# 2. 定义Pydantic模型class MovieReview(BaseModel):"""电影评论结构"""title: str = Field(description="电影标题")rating: int = Field(description="评分,1-10分", ge=1, le=10)summary: str = Field(description="剧情简介")recommended: bool = Field(description="是否推荐")@field_validator('rating')@classmethoddef rating_must_be_valid(cls, v):if v < 1 or v > 10:raise ValueError('评分必须在1-10之间')return v# 3. 定义输出解析器parser = PydanticOutputParser(pydantic_object=MovieReview)# 4. 将格式说明注入到Prompt中prompt = ChatPromptTemplate.from_messages([("system", "{format_instructions}"),("human", "评价电影《盗梦空间》")]).partial(format_instructions=parser.get_format_instructions())chain = prompt | llm | parserresult = chain.invoke({})print(f"电影: {result.title}, 评分: {result.rating}/10")
两个都是提示词(输入的一部分); 它们约束的是模型的文本输出格式。输出先是 JSON 文本,之后才可能被解析成 Python 对象。
自定义输出解析器
当内置解析器无法满足需求时,可以继承 BaseOutputParser 创建自定义解析器:
from langchain_core.output_parsers import BaseOutputParserclass CommaListParser(BaseOutputParser):"""将逗号分隔的文本解析为列表"""def parse(self, text: str):# 去除空白后按逗号分割return [item.strip() for item in text.split(",")]# 使用parser = CommaListParser()result = parser.parse("苹果, 香蕉, 橘子")print(result) # ['苹果', '香蕉', '橘子']
输出解析器选型指南
with_structured_output() | ||
JsonOutputParser | ||
PydanticOutputParser | ||
StrOutputParser | ||
BaseOutputParser |
小结:第二节围绕"如何解析模型输出",介绍了从Prompt约束到厂商原生能力,再到LangChain统一封装的多种方案。在实际开发中,我们需要将提示词模板、模型调用、输出解析这三个步骤串联起来使用。如何优雅地组合这些组件?这就是第三节的核心主题——Chains链式调用。
Chains 链式调用
在开发大模型应用时,单一组件的能力有限。真正强大的应用需要将多个组件组合起来,形成完整的工作流程。Chain(链) 正是解决这个问题的核心机制。
Chain的核心概念
简单来说,Chain是将多个组件按特定顺序组合起来完成复杂任务的工作流或管道(Pipeline)。
你可以把它想象成一个流水线:原材料(输入)经过一系列加工步骤(LLM调用、工具使用、数据转换等),最终成为成品(输出)。
虽然LLM本身很强大,但大多数实际应用需要多个步骤:
1. 接收用户输入2. 根据输入构建提示(Prompt)3. 将提示发送给LLM4. 解析LLM的输出5. 根据输出可能再执行其他操作(如调用API、查询数据库等)6. 将最终结果返回给用户
Chain的本质是自动化和封装——让我们能像搭积木一样构建复杂AI应用,使用起来却像调用一个函数一样简单。
Runnable接口
LangChain所有核心组件都实现了统一的Runnable接口。这是LangChain最底层的抽象,代表一个"可以被调用、批处理、流式传输和组合的工作单元"。
定位:LangChain中的抽象基类(ABC) 核心理念:"一切可执行的对象都应该有统一的调用方式"
Runnable核心方法
几乎所有的LangChain核心组件都实现了Runnable接口:
有了统一的Runnable接口,所有组件都可以用相同的方式调用:
prompt.invoke({"topic": "AI"}) # 提示模板model.invoke(prompt_value) # 语言模型parser.invoke(ai_message) # 输出解析器chain.invoke({"question": "你好"}) # 整个链
本质:接口统一让组件具备了"即插即用"的能力,这直接催生了 LCEL。
LCEL表达式语言
LCEL(LangChain Expression Language)是LangChain提供的声明式组合语言,专门用于组合Runnable组件。
核心操作符:管道符 |核心思想:使用 |将多个Runnable像拼积木一样组合起来
# 典型的LCEL链式写法# 1 prompt.invoke 2. model.invoke 3. output_parser.invokechain = prompt | model | output_parser# Chain本身也是Runnable,可以继续调用result = chain.invoke({"topic": "编程"})
from langchain_core.prompts import ChatPromptTemplatefrom langchain.chat_models import init_chat_modelprompt = ChatPromptTemplate.from_template("请用{tone}风格回答:{question}")model = init_chat_model(model="gpt-3.5-turbo")# LCEL组合 - 像拼积木一样简单chain = prompt | modelchain.invoke({"tone": "幽默","question": "什么是人工智能?"})
from langchain_core.output_parsers import StrOutputParserparser = StrOutputParser()# LCEL组合chain = prompt | model | parserchain.invoke({"tone": "幽默","question": "什么是人工智能?"})
LCEL的核心优势
LCEL之所以强大,是因为它背后有丰富的Runnable组合器。这些组合器让我们能够构建各种复杂逻辑。
作用:将多个Runnable按顺序连接成处理管道,前一个的输出作为后一个的输入。
from langchain_core.runnables import RunnableSequence, RunnableLambda# 显式创建序列sequence_chain = RunnableSequence(first=RunnableLambda(lambda x: x.upper()), # 第一步:转换大写middle=[RunnableLambda(lambda x: f"HELLO {x} !")], # 第二步:加装饰last=RunnableLambda(lambda x: f"最终:{x}") # 第三步:加前缀)result = sequence_chain.invoke("world")print(result) # 最终:HELLO WORLD !
LCEL等价写法(推荐):
chain = (RunnableLambda(lambda x: x.upper())| RunnableLambda(lambda x: f"HELLO {x} !")| RunnableLambda(lambda x: f"最终:{x}"))
说明:LCEL的 | 运算符底层就是创建 RunnableSequence ,推荐使用更简洁的LCEL写法。
作用:同时执行多个Runnable,将结果合并为一个字典。
from langchain_core.runnables import RunnableParallel, RunnableLambda# 创建并行任务parallel_chain = RunnableParallel({"length": RunnableLambda(lambda x: len(x)), # 计算长度"uppercase": RunnableLambda(lambda x: x.upper()), # 转大写"reversed": RunnableLambda(lambda x: x[::-1]), # 反转字符串"word_count": RunnableLambda(lambda x: len(x.split())) # 单词计数})result = parallel_chain.invoke("Hello World LangChain")# 输出:# {# 'length': 24,# 'uppercase': 'HELLO WORLD LANGCHAIN',# 'reversed': 'niahCgnaL dlroW olleH',# 'word_count': 3# }
工作原理:
同一份输入广播 : 调用 invoke(x)时,它把同一个输入x传给字典里每个runnable并发执行 : 这些 runnable会被调度为并行/并发运行(在 LangChain 的runnable运行时里实现; 对纯RunnableLambda这种本地计算,通常是并发调度;对网络 I/O(LLM/检索)收益更明显)。收集并合并结果 : 等全部分支都完成后,把每个分支的输出按 key 组装成一个 dict
LCEL等价写法(推荐):
# 字典语法自动创建RunnableParallelchain = {"length": RunnableLambda(lambda x: len(x)),"uppercase": RunnableLambda(lambda x: x.upper()),"reversed": RunnableLambda(lambda x: x[::-1]),"word_count": RunnableLambda(lambda x: len(x.split()))}# 不能单独用,单独用实际是个字典不能invoke,如果想使用一定要是一个链chain
LCEL 字典语法为什么等价?
在 LCEL 中,链里出现一个字典就会被自动编译为 RunnableParallel ;也就是说 {key: runnable} 是一种语法糖,运行时机制与 RunnableParallel({...}) 相同。
说明:每个分支是相互独立的;如果你想“某个分支依赖另一个分支的结果”,就不适合并行分叉,而要用顺序链(
|)或先并行后再用一个RunnableLambda做汇总/计算。
实际应用:先并行生成多个结果,再汇总:
from langchain.chat_models import init_chat_modelfrom langchain_core.prompts import PromptTemplatefrom langchain_core.output_parsers import StrOutputParserllm = init_chat_model(model="gpt-4o-mini", model_provider="openai")# 两个并行的解析链paragraph_1_chain = (PromptTemplate.from_template("对这首诗做解析,分析含义:{poem}")| llm | StrOutputParser())paragraph_2_chain = (PromptTemplate.from_template("对这首诗做解析,分析意境:{poem}")| llm | StrOutputParser())# 汇总链summary_chain = (PromptTemplate.from_template("第一种解析:{paragraph_1}\n\n第二种解析:{paragraph_2}\n\n请比较哪个更好,为什么") | llm | StrOutputParser())# 先并行,后汇总full_chain = {"paragraph_1": paragraph_1_chain,"paragraph_2": paragraph_2_chain,} | summary_chainresp = full_chain.invoke({"poem": "菩提本无树,明镜亦非台,本来无一物,何处惹尘埃。"})print(resp)
作用:将输入原样传递到输出,常用于保留原始输入的同时添加新字段。
from langchain_core.prompts import ChatPromptTemplateprompt = ChatPromptTemplate.from_template("请回答以下问题:{question}\n\n相关背景:{context}")chain = ({"question": RunnablePassthrough(), # 用户问题原样传递"context": lambda x: retrieve_context(x) # 检索相关上下文}| prompt| llm| StrOutputParser())
RAG典型用法——保留问题 + 检索上下文:
from langchain_core.prompts import ChatPromptTemplateprompt = ChatPromptTemplate.from_template("请回答以下问题:{question}\n\n相关背景:{context}")chain = ({"question": RunnablePassthrough(), # 用户问题原样传递"context": lambda x: retrieve_context(x) # 检索相关上下文}| prompt| llm| StrOutputParser())
作用:将普通Python函数包装为Runnable,使其可以在LCEL链中使用
from langchain_core.runnables import RunnableLambdadef extract_domain(url):"""从URL中提取域名"""return url.split('//')[-1].split('/')[0]def add_protocol(domain):"""添加协议前缀"""return f"http://{domain}"# 包装成Runnabledomain_extractor = RunnableLambda(extract_domain)protocol_adder = RunnableLambda(add_protocol)# 在链中使用url_processor = domain_extractor | protocol_adderresult = url_processor.invoke("https://www.example.com/path")# 输出:"http://www.example.com"
Runnable接口提供的完整方法集:
chain.invoke({"topic": "AI"}) | ||
for chunk in chain.stream({...}) | ||
chain.batch([{"topic": "AI"}, {"topic": "猫"}]) | ||
await chain.ainvoke({...}) | ||
async for chunk in chain.astream({...}) | ||
await chain.abatch([...]) |
构建对话系统时,需要让链"记住"之前的对话内容:
from langchain_core.runnables.history import RunnableWithMessageHistoryfrom langchain_core.chat_history import InMemoryChatMessageHistoryfrom langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholderfrom langchain_openai import ChatOpenAI# 创建会话存储(以session_id为key)store = {}def get_session_history(session_id: str):"""获取会话历史记录"""if session_id not in store:store[session_id] = InMemoryChatMessageHistory()return store[session_id]# 创建基础链prompt = ChatPromptTemplate.from_messages([("system", "你是AI助手"),MessagesPlaceholder(variable_name="history"),("human", "{input}")])llm = ChatOpenAI(model="gpt-4o-mini")chain = prompt | llm# 包装为带历史记录的链chain_with_history = RunnableWithMessageHistory(chain,get_session_history,input_messages_key="input",history_messages_key="history")# 使用时指定session_idresponse_1 = chain_with_history.invoke({"input": "我叫张三"},config={"configurable": {"session_id": "user123"}})print(response_1.content)# 后续对话会自动携带历史response_2 = chain_with_history.invoke({"input": "我叫什么名字?"},config={"configurable": {"session_id": "user123"}})print(response_2.content)# AI会回答"你叫张三",因为历史记录中有这个信息
高级模式
错误处理与重试
# 使用with_retry自动重试chain_with_retry = prompt | llm.with_retry(stop_after_attempt=3) | parser
回退机制
主模型失败时自动切换备用模型:
primary_llm = ChatOpenAI(model="gpt-4o")fallback_llm = ChatOpenAI(model="gpt-4o-mini")chain_with_fallback = prompt | primary_llm.with_fallbacks([fallback_llm]) | parser
小结
核心概念总结
代码模板速查
# 基础链chain = prompt | llm | StrOutputParser()result = chain.invoke({"topic": "AI"})# 结构化输出class Result(BaseModel):answer: strconfidence: floatstructured_llm = llm.with_structured_output(Result)# 并行链parallel = {"en": translate_chain_en,"kr": translate_chain_kr}# 带对话历史chain_with_history = RunnableWithMessageHistory(chain, get_session_history, ...)

