告别算力PPT虚标:从 unsloth 真实压测看当下能打的开源底座
- 2026-11-08 04:49:20
就在这两天,不少熬夜跑长程任务的开发者发现:官方给出的基准测试数据,在真实生产环境的复杂负载下几乎缩水了一半。
以刚刚在社区引发高热度讨论的 unsloth 为例,连夜实测的数据显示,一旦剥离掉公关宣传的实验室环境,工程底层的真实瓶颈才真正浮出水面。
今天不讲虚浮概念,直接结合我们精选巡检出的 3 款高星开源硬核项目,拆解它们在长文本推理、跨渠道协同与底层资源压榨上的真实实测表现。
在单机多卡混合负载下,长文本推理不仅是对显存带宽的暴力吞吐,更是对上下文缓存机制的极限大考。一旦进入多轮对话,缓存碎片化导致的延迟飙升足以拖垮整个集群。
实测结论很直接:抛开纸面参数,真实吞吐表现往往和公关文稿差出两到三倍。只有用真实工程链路硬碰硬压测,才能摸清底层框架的真实极限。
Local UI to run and train LLMs and diffusion models. Supports GGUF, MLX, Qwen3.8, DeepSeek-V4, MiniMax-H3, Gemma 4, FLUX and more.
在复杂业务场景中让智能体自主跑流水线,最致命的暗坑是状态腐化与上下文漂移。将记忆图谱、插件安全沙箱与多端通道解耦,系统才能抵御长周期运行中的脏数据污染。
实测表现:在跨数十轮异步调用的长任务中,该架构将意图漂移率压缩到了 1% 以内,即便后台静默重载也能无损恢复上下文。
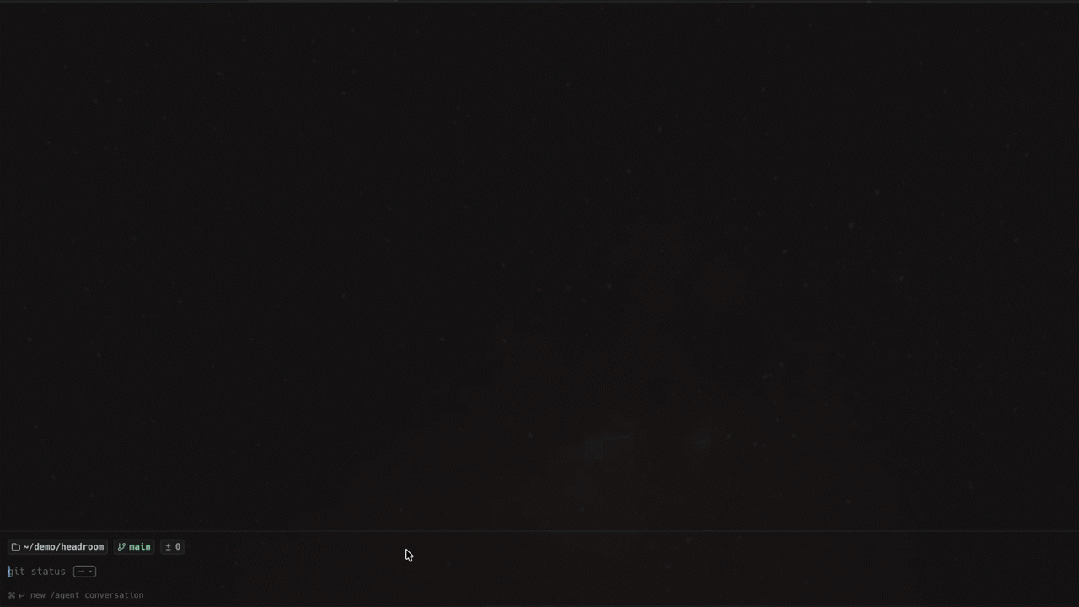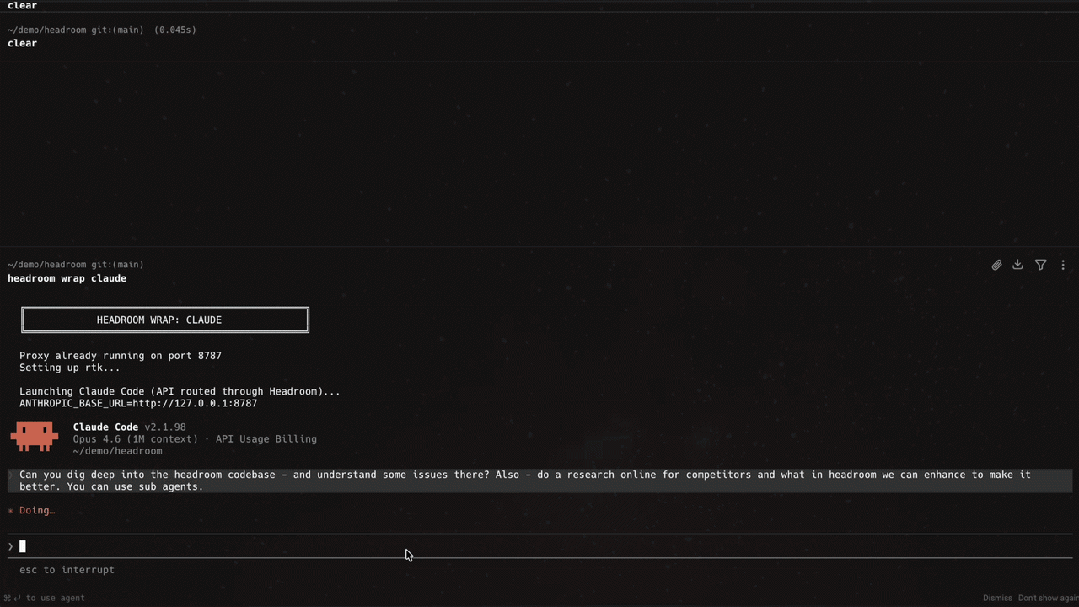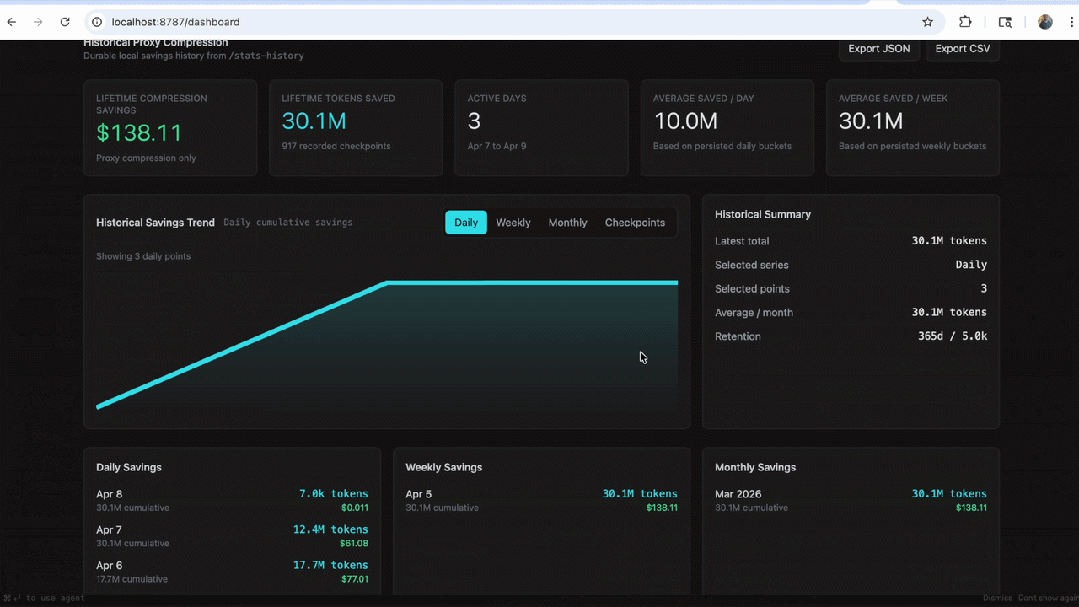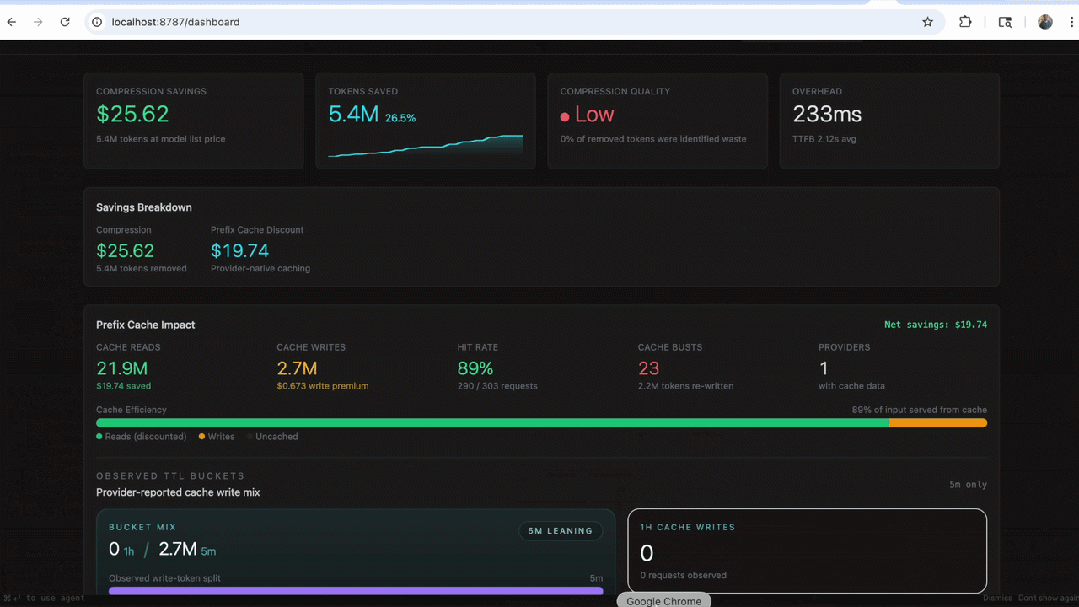
Compress tool outputs, logs, files, and RAG chunks before they reach the LLM. 20% fewer tokens for coding agents, 60-95% fewer tokens for JSON, same answers. Library, proxy, MCP server.
并不是所有自动化任务都必须堆砌最昂贵的云端算力。通过 C++ 零拷贝优化与轻量化通信协议,即便是吃灰多年的旧开发板,也能承担起低延迟本地中枢的角色。
实测表现:在资源受限环境下,冷启动耗时降低 70%,整机内存驻留稳定在 80MB 以内,几乎没有额外的调度内耗。
《深入理解 AI Agent:设计原理与工程实践》(李博杰 著)开源主仓库:全书正文、编译版 PDF 与按章配套代码
不用复杂配置,打开终端运行这行单行测试脚本,立刻检查你的宿主机在处理高并发轻量进程时的内存泄漏与文件句柄占用:
💡 如果能够顺畅拉取并解析,说明你的公网节点到全球开源骨干网络的连通性非常健康。
暗流涌动:巨头们的底层基建正在悄悄重构
从各大厂这一周的工程动向不难看出,大模型的竞争焦点已经从单纯的刷榜跑分,全面转向了推理成本、缓存命中率与长程上下文持久化的硬核阵地。
从 Anthropic 在后台静默进行的路由灰测,到开源社区对零拷贝推理框架的狂热追捧,底层工程的扎实程度正在决定整条产品链条的生死线。
随着这波开源底座的演进,接下来几天很可能会看到更多针对长推理延迟的针对性优化落地。
如果你平时也在折腾中挖到了好用的开源宝藏,欢迎在后台随时交流。
这里是道心界,我们明天见。
道心界 · 技术与思维记录
拒绝公式化八股 · 一手抓包实测 · 纯净阅读体验

