(内附PPT解读)AI模型落地难?——为胰腺癌风险模型找到临床“最优解”
- 2026-11-06 08:03:31
点击蓝字 关注我们
点击翻页
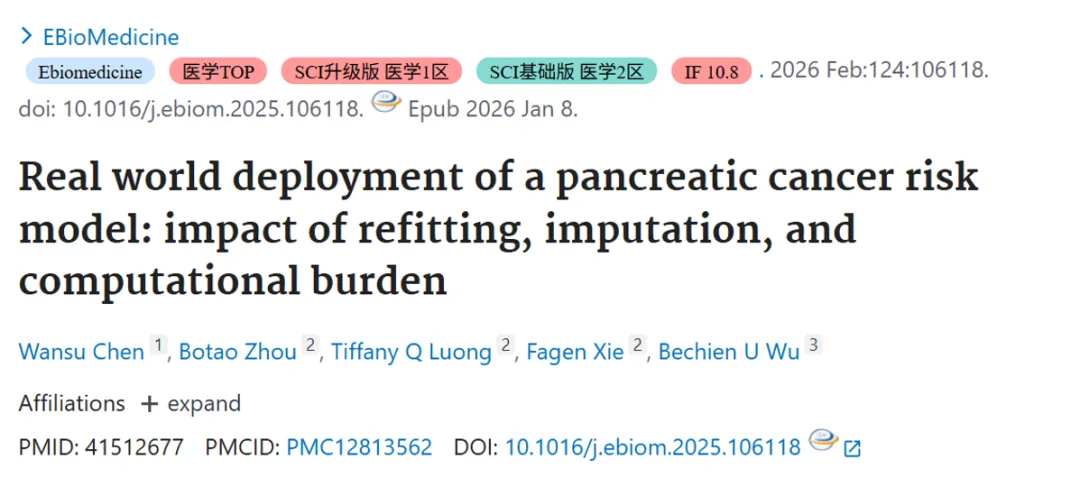
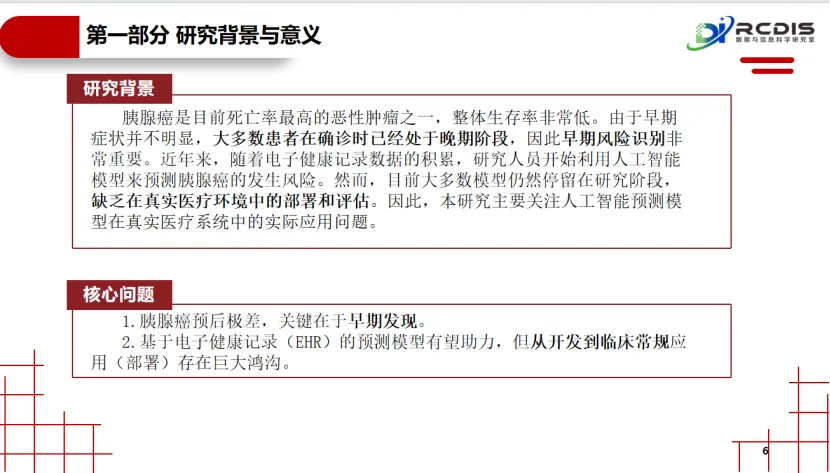
胰腺癌素有“癌王”之称,五年生存率仅12.8%。早期发现是提高生存率的关键,而利用电子健康记录(EHR)数据构建的预测模型为此带来了希望。然而,一个模型在回顾性研究中表现优异,并不代表它能顺利应用于真实临床场景。模型部署的“最后一公里”面临哪些实际挑战?又该如何应对?
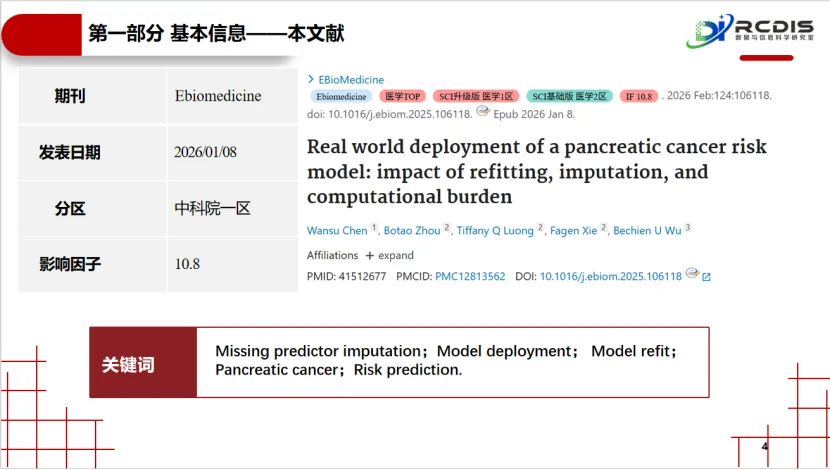
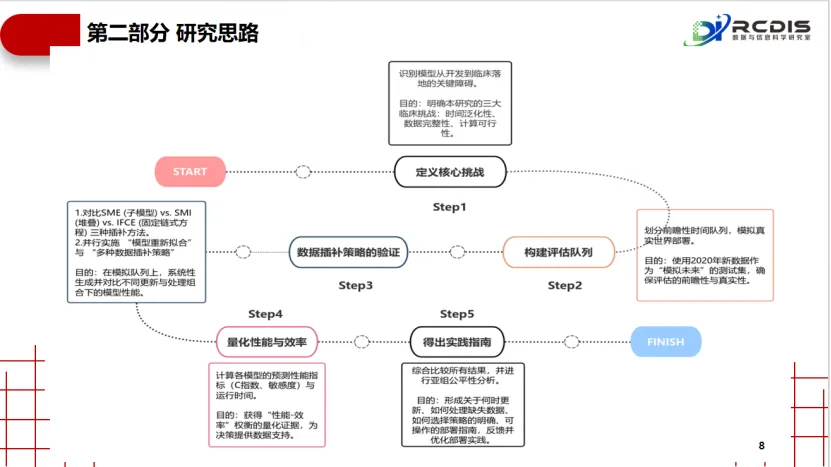
近期,一项发表在《eBioMedicine》上的研究,以前瞻性视角深入探讨了胰腺癌风险预测模型在真实世界部署中的三大核心问题:
1. 模型是否需要随时间更新(重新拟合)?
2. 如何处理预测时普遍存在的缺失数据?
3. 计算负担是否可承受?
研究亮点
对“模型过时”的验证:研究模拟了时间效应,通过对比用旧数据训练的原始模型与用新近数据重新训练的模型,在未来患者队列中的表现差异。这直接证实了“数据漂移”的存在,为“临床AI模型需要定期维护与更新”这一常常被忽视的实践,提供了关键证据。
对“数据不完整”的实战测评:面对现实世界中患者信息普遍缺失的难题,该研究首次系统性地将三种主流缺失值处理策略置于部署场景中同台竞技。其评估维度远超常见的预测精度,创造性地纳入了“计算可行性”与“运维复杂性”这两个决定性的落地指标。
对“计算效率”的压力测试:研究设计了一个高度仿真的工作流——将超过35万患者数据,模拟为连续53个“周批次” 进行滚动预测与评估。这种方法能够精确记录每一种方案在模拟的真实工作节奏下的数据提取、处理和计算耗时。
这项研究通过搭建这样一个严谨的“模拟-评估”闭环,将部署前抽象的担忧,转化为可量化、可比较的实测结果。它标志着临床AI评估范式从静态的“性能评估”,转向动态的“生存能力评估”,为后续所有旨在落地的模型,提供了一个极具价值的创新方法范本。
研究背景
(下方为本部分的汇总图示,可左右滑动查看)
<< 滑动查看下一张图片 >>
01
原模型文献基础
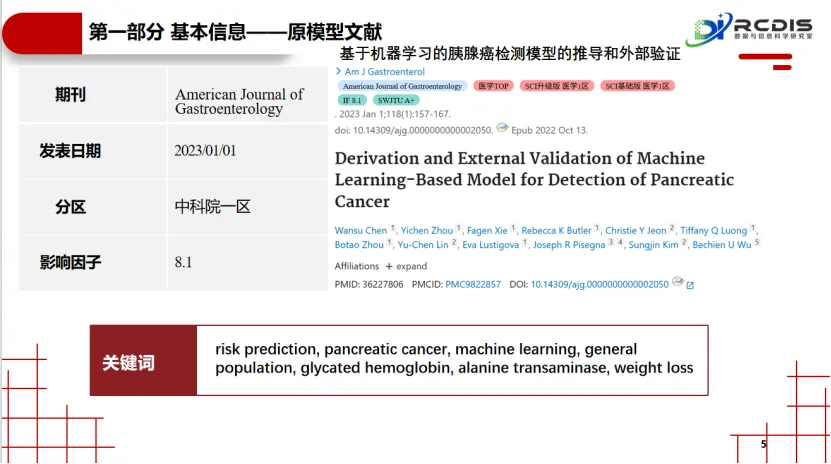
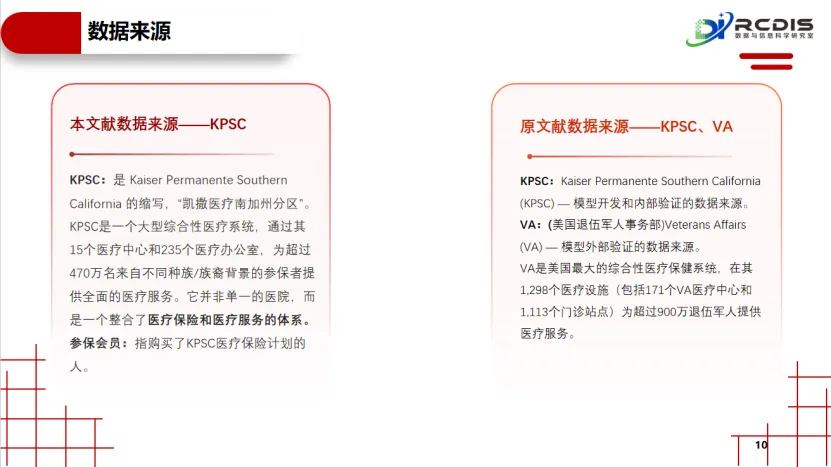
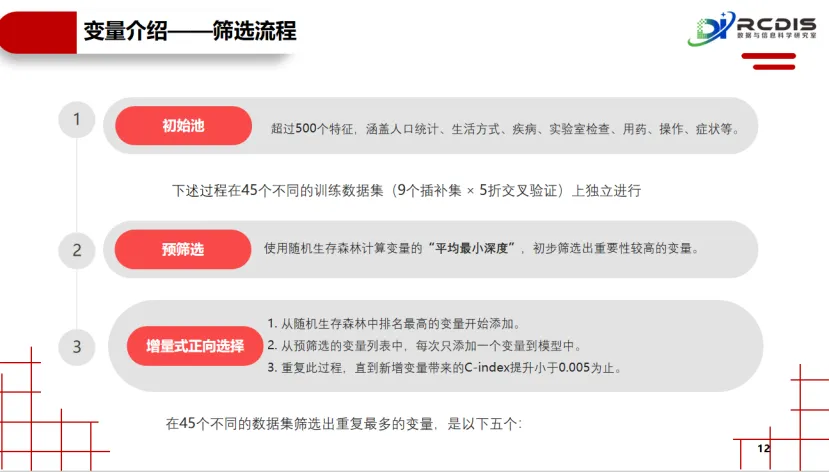
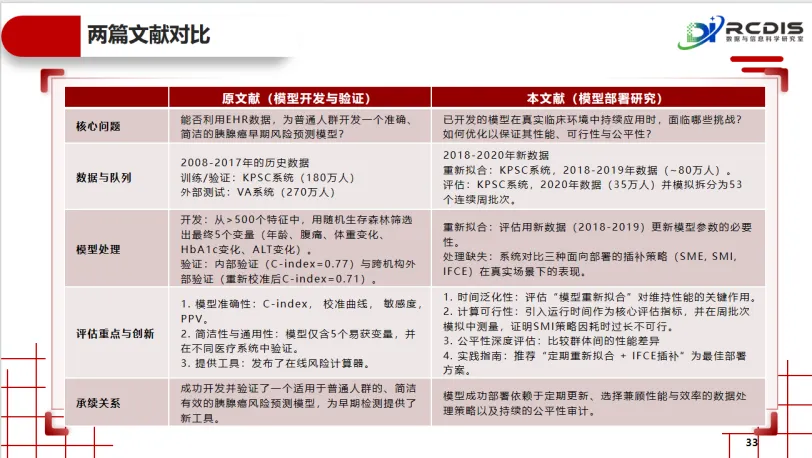
本研究评估的模型源于2023年发表于 《American Journal of Gastroenterology》 的先前研究。该原研究利用机器学习(随机生存森林)从超过500个特征中,筛选出5个简洁的预测变量,成功开发并验证了一个适用于普通人群的胰腺癌风险预测模型。
02
明确的临床挑战
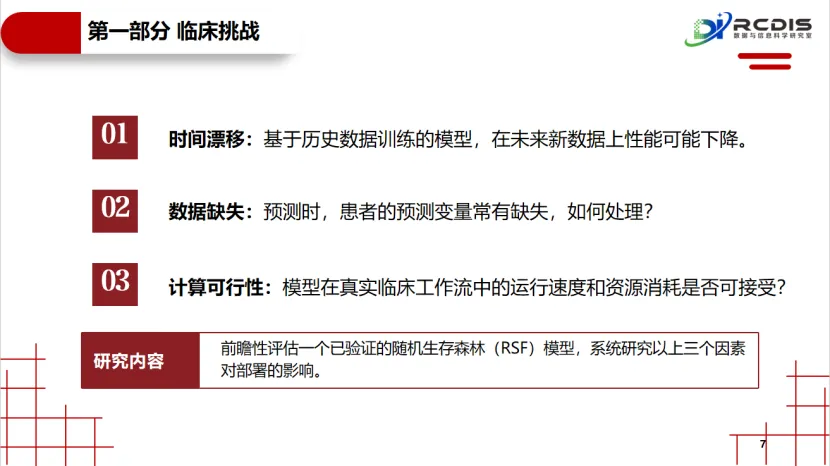
研究指出了模型落地必须直面的三大核心难题:
时间漂移:基于历史数据训练的模型,在未来新患者群体上的性能可能衰退。
数据缺失:在临床实时预测时,患者的预测变量常常不完整,如何可靠处理?
计算可行性:模型在真实的医院工作流中,其运行速度和资源消耗是否能被接受?
研究方法与思路
(下方为本部分的汇总图示,可左右滑动查看)
<< 滑动查看下一张PPT >>
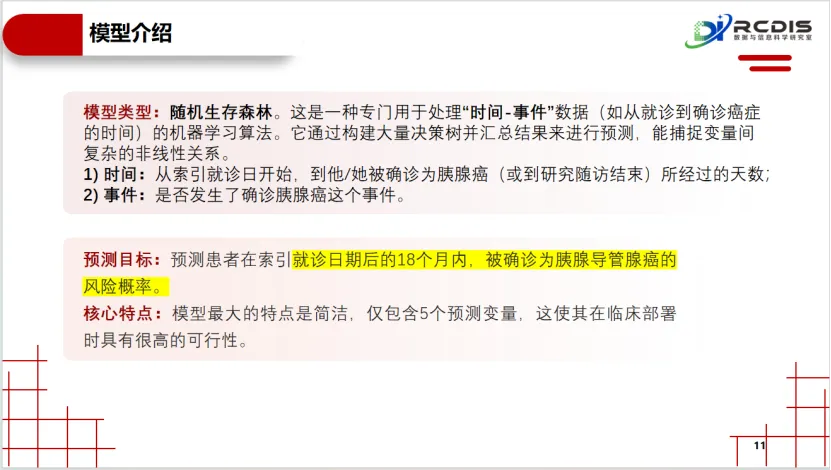
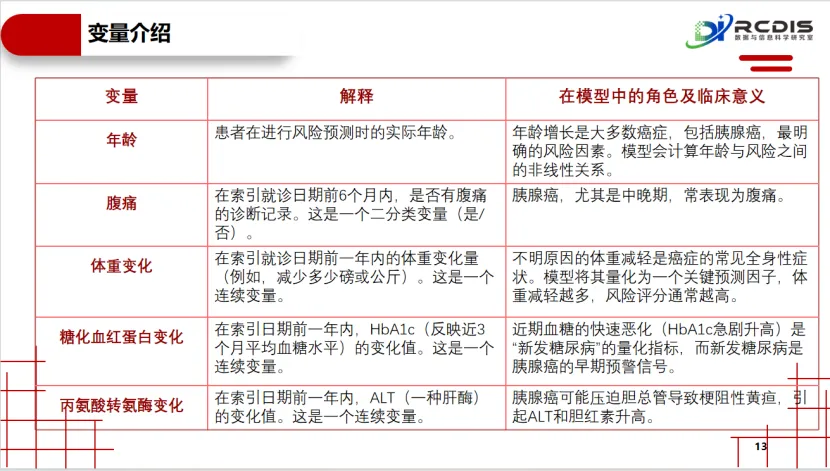
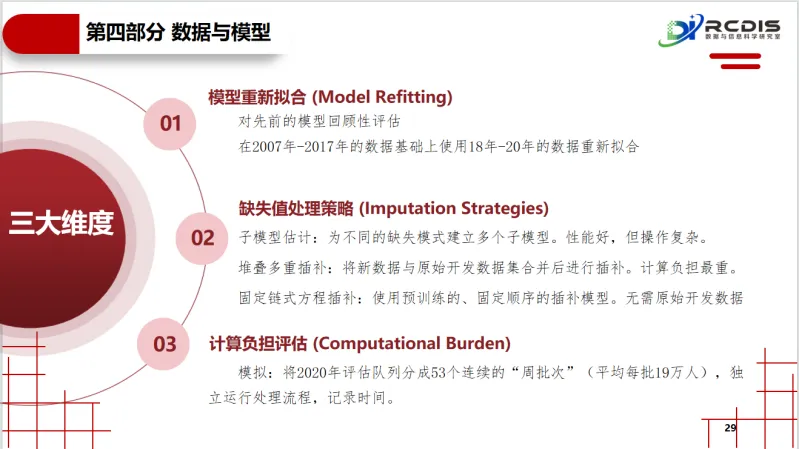
模型与数据:以已开发的、仅包含5个关键变量(年龄、腹痛、体重变化、糖化血红蛋白变化、丙氨酸转氨酶变化)的随机生存森林模型为基础,使用大型医疗系统(KPSC)2018-2020年的新数据。
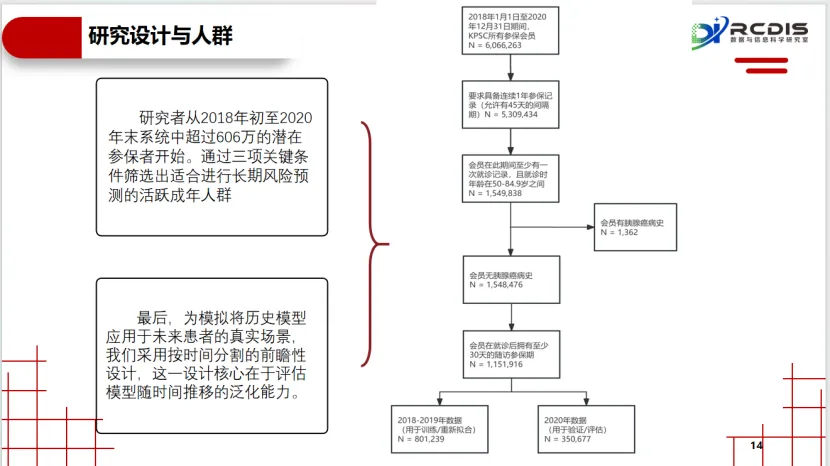
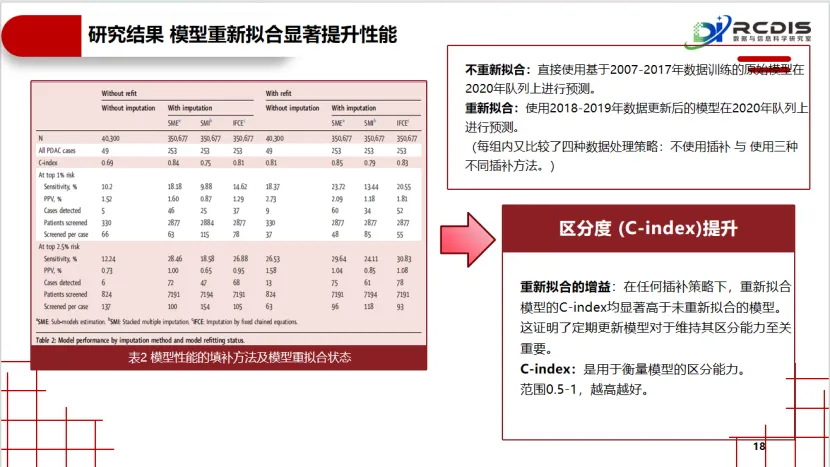
前瞻性评估设计:采用按时间分割的前瞻性队列设计。使用2018-2019年数据对模型进行“重新拟合”,然后在全新的2020年患者队列中评估其性能,直接测试模型的时间泛化能力。
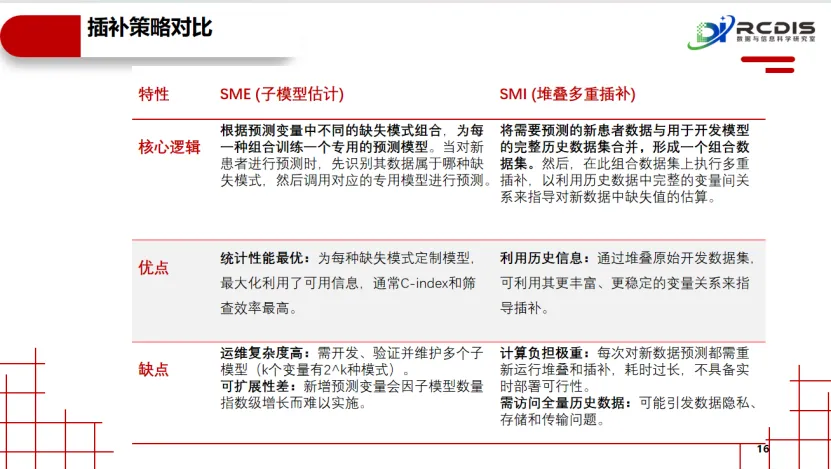
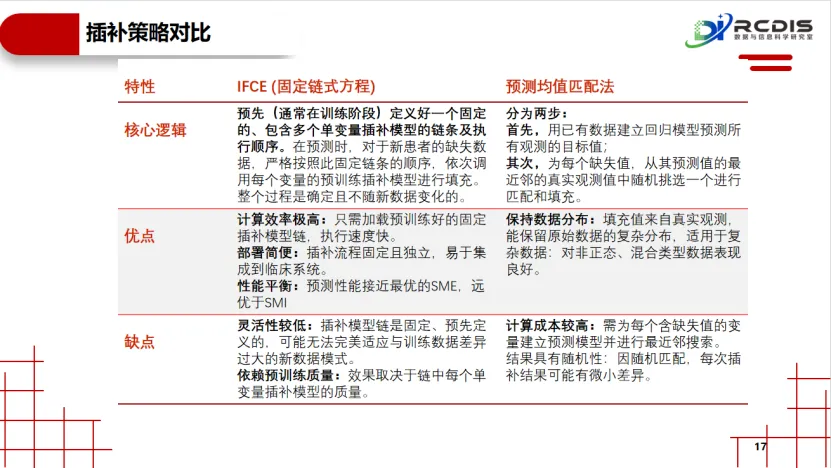
系统化对比解决方案:针对数据缺失问题,首次在部署场景中系统对比了三种主流插补策略,分别是子模型估计、堆叠多重插补、固定链式方程插补法。
研究结果
(下方为本部分的汇总图示,可左右滑动查看)
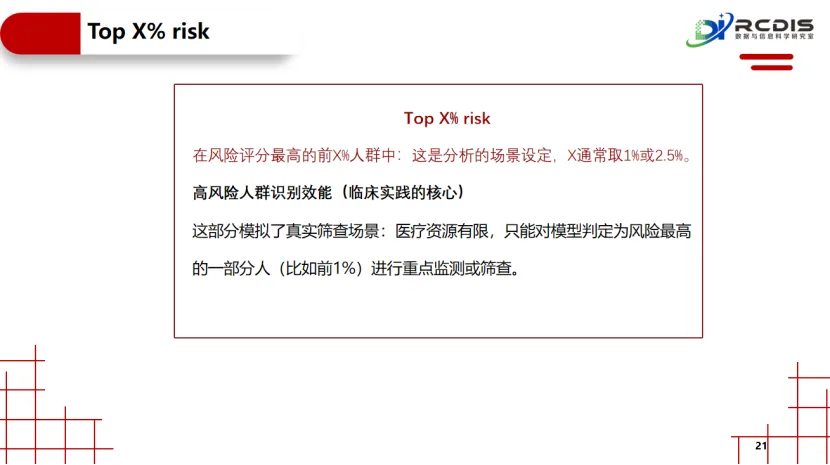
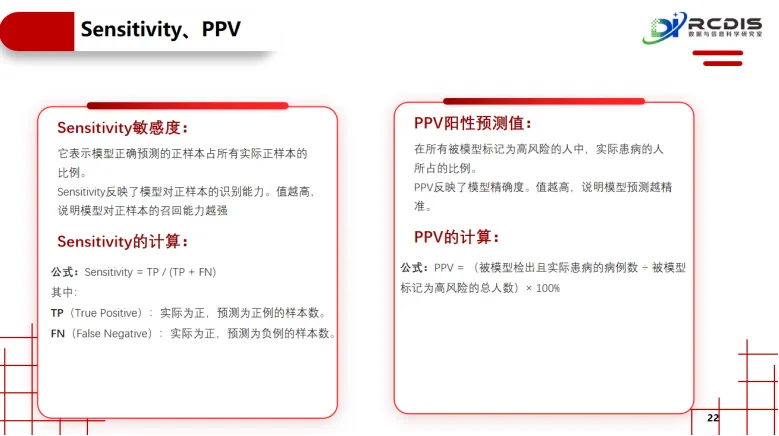
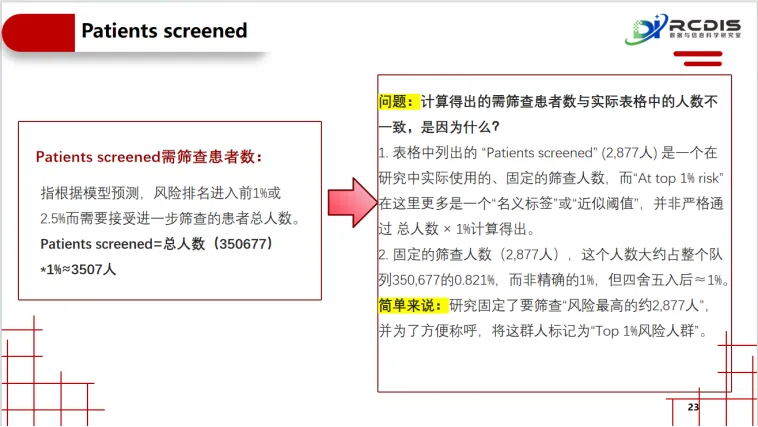
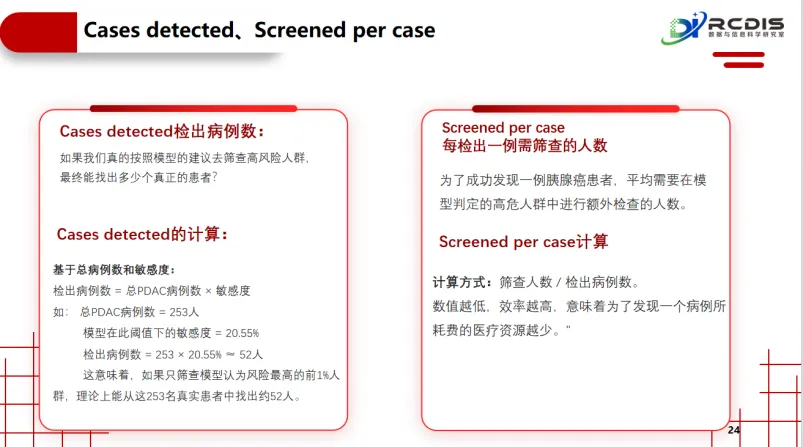
<< 滑动查看下一张PPT >>
一
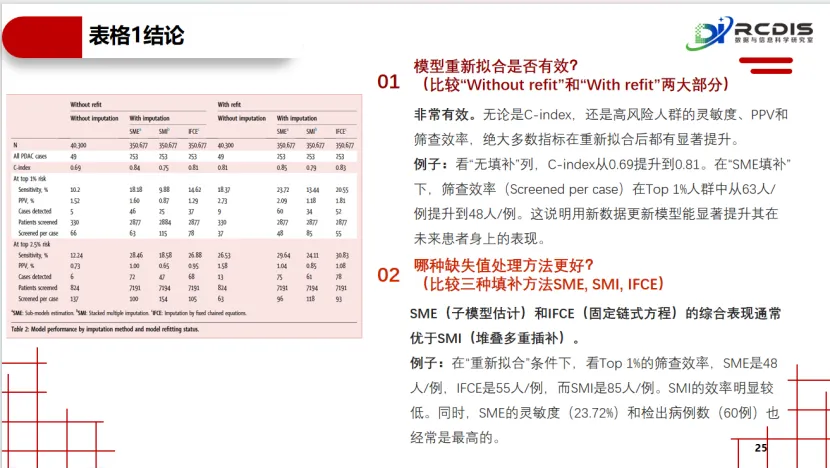
模型必须“与时俱进”:重新拟合至关重要
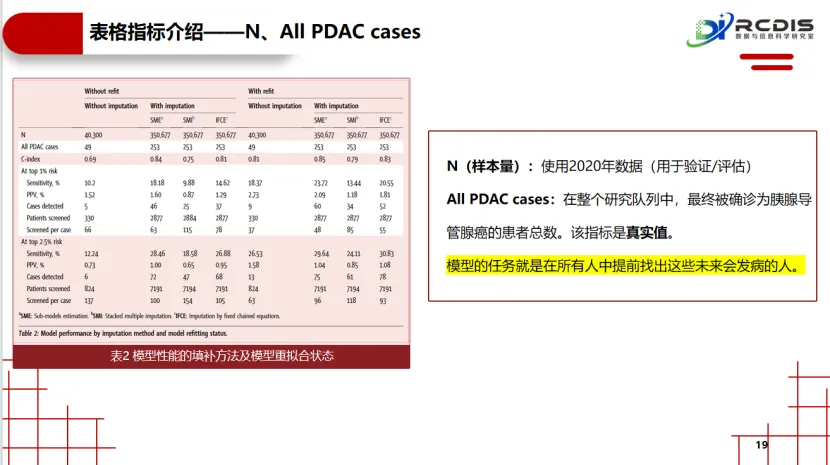
研究证实了“数据漂移”的真实存在。使用2018-2019年新数据重新拟合后的模型,在2020年队列上的各项性能指标均显著优于未经更新的旧模型。例如,PPT中表格数据中,重新拟合后的数据明显优于拟合前的数据。这为建立定期的模型更新与维护机制提供了关键证据。
二
处理缺失数据:关键在于精准权衡
研究首次在部署场景下,对三种缺失值处理策略进行了全面的性能与效率对比:
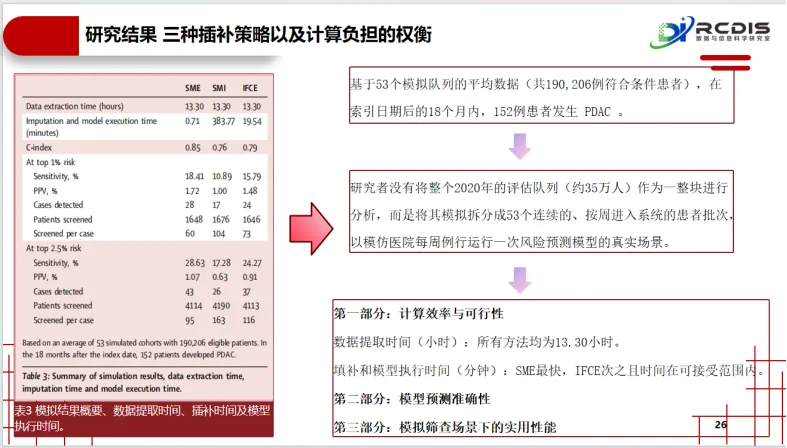
子模型估计:预测性能最佳(如重新拟合后C-index达0.85),但需要构建并维护多个模型,运维复杂度最高。
堆叠多重插补:统计原理严谨,但计算负担巨大,在53个周批次的模拟中,平均单批插补与执行时间长达6个多小时,导致其不具备临床常规应用的可行性。
固定链式方程插补:在性能、效率与可行性间取得了最佳平衡。其预测性能(C-index 0.83)接近最优,同时计算效率极高(单批约20分钟),且无需调用原始敏感数据,因此被确定为最具现实部署潜力的推荐方案。
三
计算负担是决定性的现实约束
模拟每周批次的“压力测试”结果,将“运行时间”从一个抽象概念转化为具体决策依据。数据显示,SMI方法因耗时过长而难以融入真实工作流,而IFCE方法的高效性是其能够落地的关键优势。这凸显了在模型部署中,计算可行性是与预测准确性同等重要的评估维度。
四
模型公平性:性能存在群体差异
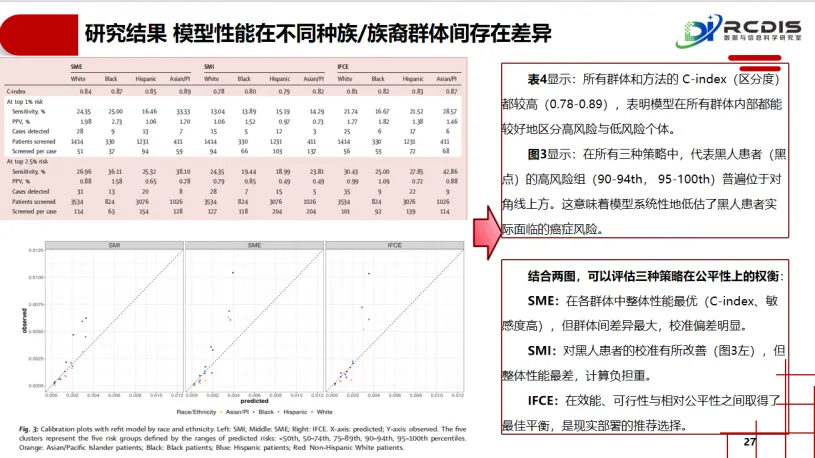
研究评估了模型在不同种族/族裔群体中的表现。虽然所有群体内部的区分度都较高,但校准曲线显示,模型系统性地低估了黑人患者面临的真实风险。这意味着在相同风险评分下,黑人患者实际患病概率高于预测值。这一发现警示,在模型部署前与部署后,必须进行跨亚组的公平性审计,并考虑采取校准等措施以促进健康公平。
结论与讨论
(下方为本部分的汇总图示,可左右滑动查看)
<< 滑动查看下一张PPT >>
1
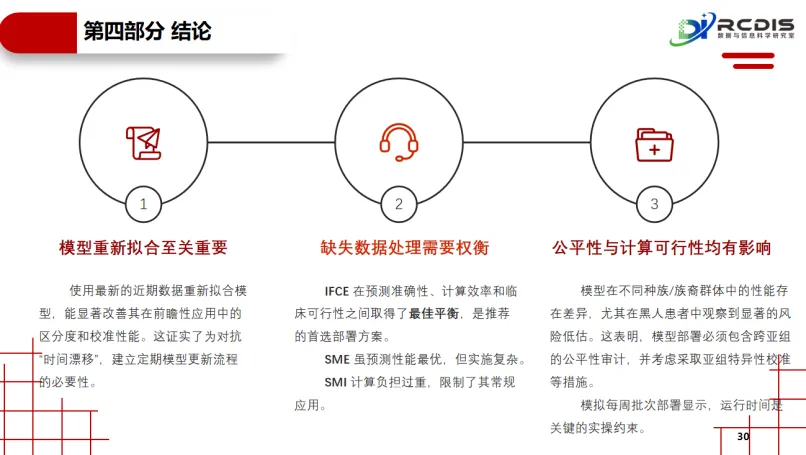
研究结论:
模型重新拟合至关重要
缺失数据处理需要权衡:在三种策略中,固定链式方程插补在预测性能、计算效率和临床可行性之间取得了最佳平衡,是推荐的首选部署方案
公平性与计算可行性均有影响
2
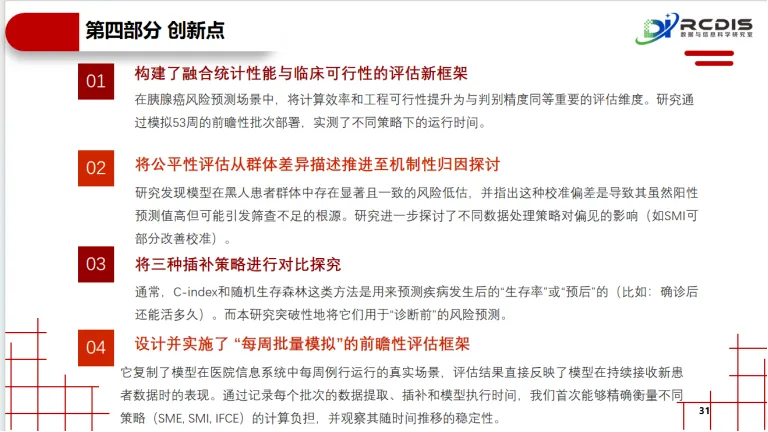
研究创新点:
构建了融合统计性能与临床可行性的评估新框架
深化了公平性评估
系统对比了三种插补策略在部署场景中的表现
设计了“每周批量模拟”的前瞻性评估框架
3
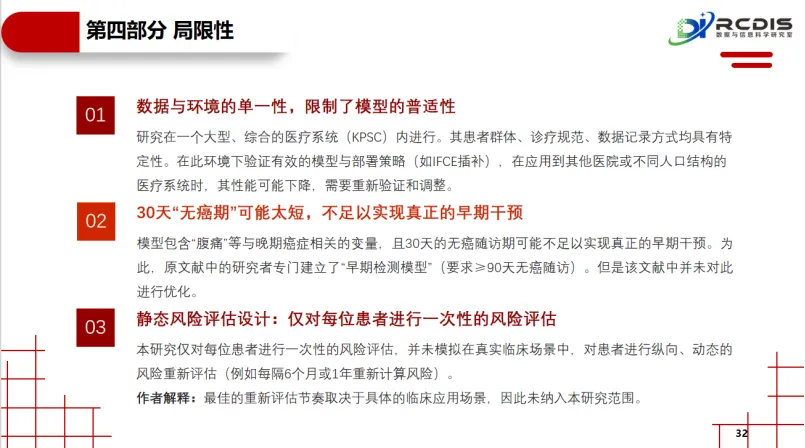
研究局限性:
数据与环境的单一性
早期检测的时效性存疑
静态风险评估设计
这项研究如同一份详尽的“地图”,标出了从算法论文到临床病房这条路上主要的沟坎与桥梁。通过与原模型开发文献对比,本研究完成了从“模型能否建好”到“模型如何用好”的跨越。它强调,一个成功的临床AI工具,其长期价值不仅取决于开发的准确性,更依赖于可持续的更新流程、兼顾效能与效率的数据处理策略,以及贯穿始终的公平性考量。
药小象AI统计
文案编辑丨法如扎
排版设计丨法如扎
策划指导丨梁露花
审核顾问丨项荣武

