用Excel手搓神经网络4:反向传播算法(下)
- 2026-11-06 22:44:49
用Excel手搓神经网络3:反向传播算法(上)
上一期已经对反向传播有了直观感受,看计算过程的第一感觉就是反向传播一点都不玄乎,它的核心逻辑,就是一个迭代往复修改错误的过程,其实就是每天都在做的一件事——「知错就改」,只不过机器把这个过程做得更精准、更高效而已。
先搞懂:没有反向传播,你就是“瞎调整”
第一步:你凭感觉调整(对应神经网络「前向传播」)
第二步:明确“差距”(对应「计算损失/误差」)
反向传播核心:从成绩倒推,精准调整4个时间变量
第一步:先定“错多少”——算出总误差
第二步:倒着找“谁该背锅”——分配误差(找问题变量)
早读时间(1小时):孩子反馈,早读时间太短,英语单词、语文古诗文记不牢,每次考试这两块都要丢20分——这是一个明显的误差来源; 作业时间(3小时):孩子说作业太多,很多重复题浪费时间,重点错题的覆盖率很低,针对性差,同时写到深夜很疲劳,第二天上课走神,数学、物理的基础题会丢15分——这是第二个误差来源; 休息时间(7小时):看似休息充足,但孩子熬夜写作业,实际深度睡眠只有4小时,白天效率低,间接影响所有科目,大概丢10分——第三个误差来源; 辅导班时间(2小时):辅导班讲的内容太基础,孩子已经掌握,相当于浪费时间,还占用了自主复习的时间,大概丢25分——这是影响最大的误差来源。
第三步:精准改错——调整每一个变量(对应更新参数)
辅导班时间(影响最大,丢25分):从2小时减少到0.5小时,只保留薄弱科目(比如化学)的辅导,剩下1.5小时,一部分给早读,一部分给休息; 早读时间(丢20分):从1小时增加到1.5小时,重点背诵英语单词、语文古诗文,解决基础丢分问题; 作业时间(丢15分):从3小时减少到2.5小时,筛选掉重复题、基础题,重点做错题和拔高题,避免浪费时间; 休息时间(丢10分):保持7小时总休息时间,调整作息,保证孩子23点前睡觉,增加深度睡眠,提高白天学习效率。
第四步:重复迭代——越调越准(对应神经网络训练)
再测试(前向传播):按新的时间安排,孩子坚持1个月,参加第二次摸底考试,成绩提升到630分,误差从70分缩小到20分; 倒着找错(反向传播):再次复盘,发现误差只剩下20分,主要来自:早读时间还是不够(丢8分)、作业里的拔高题没练够(丢7分)、休息时间虽够但白天专注力不足(丢5分),辅导班已经没问题; 再微调(更新参数):早读增加到1.8小时,作业增加0.2小时专门练拔高题,调整孩子白天的学习节奏(每学习1小时休息10分钟),辅导班保持0.5小时;
对应到神经网络,其实就是这么回事
你控制的「4个时间变量」(早读、作业、休息、辅导班)→ 神经网络的「每一层参数」(机器用来计算、预测的核心依据); 孩子的「摸底考试成绩」→ 神经网络的「预测结果」(机器根据参数,算出的答案); 「650分的目标成绩」→ 我们给机器的「真实标签」(比如图片里是猫,就告诉机器正确答案是猫); 「成绩差距(误差)」→ 神经网络的「损失值」(预测结果和真实答案的差距); 「反向传播」→ 从成绩差距(误差)出发,倒着分析每个时间变量(参数)的影响,再针对性调整,让下次摸底成绩(预测结果)更接近目标(真实标签)。
反向传播,就是机器的“备考复盘法”
那么回到Excel大模型系类,如何修正参数,就是靠右边几个蓝色矩阵,不过很可惜,Tom老师没接着。需要你自己动手添加两个表格。看下边截图,对照文字应该能看懂。
从右下角,损失对输出层线性变换结果的梯度开始定义,记dL3 = ∂L/∂Z₃,该值即为损失函数对 Z₃的梯度。这里需要说明的是,若输出层激活函数为 Softmax,推导中直接将 dL3 简化为预测值与真实值的差值,这一简化并非随意处理,而是由 Softmax 函数结合交叉熵损失的数学特性所决定 —— 二者联合求导后会消去复杂的指数项,最终梯度形式可直接简化为差值,大幅降低计算复杂度。
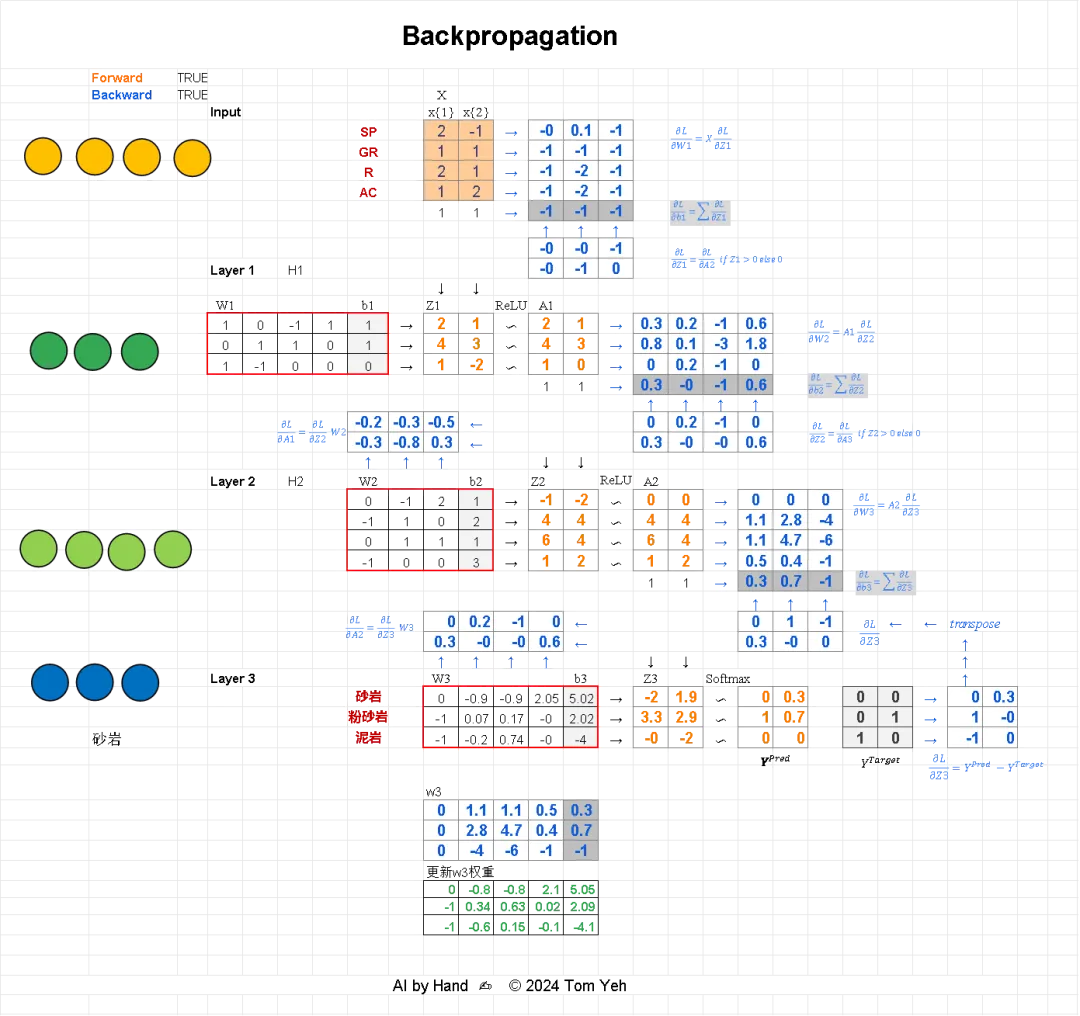
得到 dL3 后,继续向上游推导权重参数的梯度:将 dL3 做转置变换(仅调整矩阵维度以匹配运算要求,不改变数据本身),再与前一层的输出 A₂做矩阵乘法,即可得到损失对输出层权重 W3 的梯度,即dW3 = ∂L/∂W₃,该值直观反映了权重 W3 的微小变化对整体损失的影响程度,是参数更新的核心依据。
接下来是关键的参数修正步骤:以 W3 的更新为例,先将梯度矩阵 dW3 做转置(与原始 W3 矩阵形状保持一致,对应推导中绿色 ,蓝色矩阵的维度匹配要求),再将其乘以学习率 η(本次示例中 η=0.1),最后用权重原始值减去该乘积(注:梯度下降法为原值 - 学习率 × 梯度,而非相加,核心是沿着损失降低的方向更新),即可得到修正后的新权重 W3',公式为:W3' = W3 - η × dW3ᵀ
按此规则对示例中参数逐一更新:首个参数保持 0 不变,第二个参数从 1 更新为 - 0.9,0.5 更新为 2.06,0.2 更新为 5.02。从更新结果能明显看出,参数数值变化幅度过大,这意味着学习率 0.1 的设置偏高—— 学习率过大易导致参数在最优解附近震荡,甚至无法收敛,因此实际训练中需将学习率适当降低(如调整为 0.01、0.001 等),让参数以更平缓的节奏向最优值逼近。
将更新后的新参数重新代入网络进行前向传播,模型输出会随之改变,该结果可能尚未达到预期,但神经网络的训练本就是多轮迭代循环的过程:每一轮都按 “计算梯度→更新参数→验证输出” 的逻辑反复优化,通过数十、数百甚至数千轮迭代,参数会逐步收敛到最优值,最终让模型输出贴合真实目标。
参考书籍推荐(清华大学出版社,适配深度学习梯度推导 / 参数优化知识补充)
结合你提供的清华社链接(https://www.tup.tsinghua.edu.cn/upload/books/yz/088732-01.pdf),该文档为《深度学习与交通大数据实战》核心章节,其中3.1 反向传播算法部分(124-132 页)详细讲解了梯度计算、权值更新的数学推导与 NumPy 实现,与本次的损失梯度、参数更新知识点高度契合,可作为核心参考;
若需更系统的深度学习基础补充,推荐清华社同系列 / 同领域经典教材:
《深度学习入门:基于 Python 的理论与实现》(斋藤康毅 著,清华社引进):零基础讲解反向传播、梯度下降的数学原理,配套极简代码实现,适合理解参数更新的底层逻辑; 《深度学习框架 PyTorch:入门与实践》(陈云 著,清华社):第 3-4 章详细讲解神经网络参数优化、学习率调优策略,包含大量实战案例,适配工程化落地; 《神经网络与深度学习》(邱锡鹏 著,清华社):第 2-3 章对 Softmax + 交叉熵损失的梯度简化、梯度下降变种(SGD/Adam)做了严谨的数学证明,适合深入研究理论细节。
以上书籍均可在清华大学出版社官网(tup.tsinghua.edu.cn) 检索电子版 / 纸质版,也可通过知网、超星等平台查阅相关章节。